

JEV人工智能官网入口:Jev AI国内访问与申请教程
2026-09-20
2026-09-24 0
Muse Spark 1.2 Contributor 不是单独训练的小模型,而是 Muse Spark 1.2 的低价服务档位,接口模型 ID 为 muse-spark-1.2-contributor。它与标准版共享 1,048,576 tokens 上下文和多模态输入能力,核心差别在数据使用约定、价格与调用额度:选择 Contributor,意味着允许 Meta 使用提交的提示词和模型输出训练未来模型,以此换取更低的 tokens 单价。
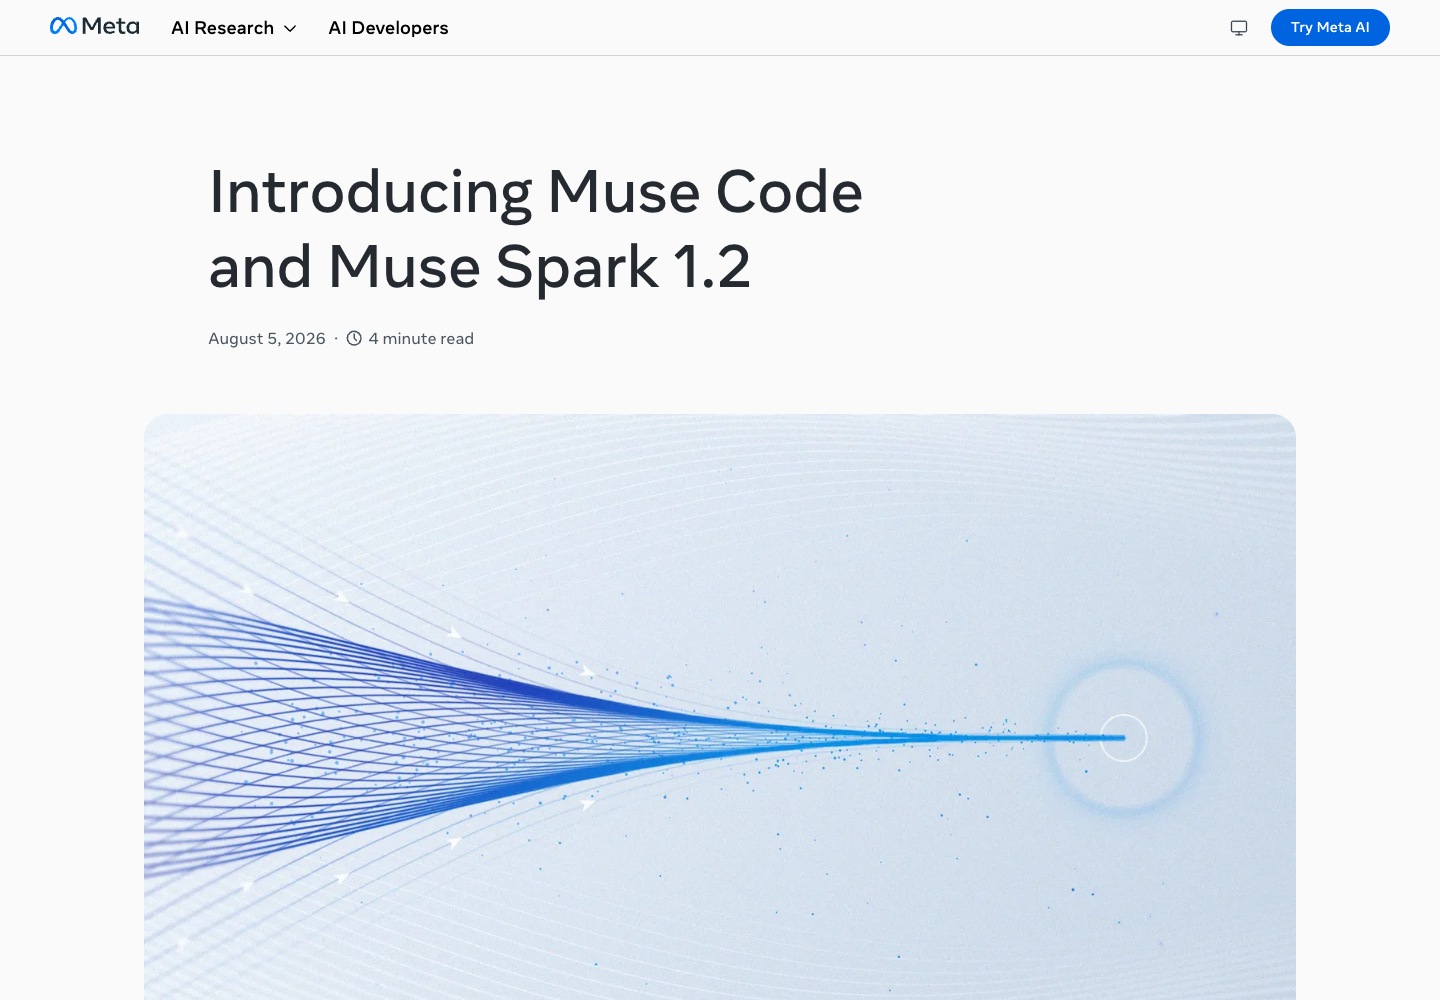
图:Muse Spark 1.2 与 Muse Code 的官方发布页面。Contributor 是该版本在 Meta Model API 中提供的服务档位之一。截图于 2026 年 9 月 23 日获取,来源:Meta AI Research。
“Contributor”能够理解为“以数据授权参与模型改进”。开发者支付较低的调用费用,同时允许平台把请求与输出用于后续模型训练。它描述的是服务和数据处理方式,不是模型规模、量化等级或推理速度标签。
Meta 当前为 Muse Spark 1.2 和 1.3 提供 Contributor 版本:
muse-spark-1.2-contributormuse-spark-1.3-contributorMuse Spark 1.1 只有标准档位,没有官方 Contributor 模型 ID。调用时必须使用完整 ID;把 -contributor 删除后,请求会转到对应的标准计费模型,价格和数据规则也会随之改变。
| 对比项 | 1.2 Contributor | 1.2 标准版 |
|---|---|---|
| 模型 ID | muse-spark-1.2-contributor |
muse-spark-1.2 |
| 上下文窗口 | 1,048,576 tokens | 1,048,576 tokens |
| 输入类型 | 文本、图片、视频、音频、PDF | 文本、图片、视频、音频、PDF |
| 输出类型 | 文本 | 文本 |
| 提示词与输出 | 可用于训练未来模型 | 不用于训练 Meta 模型 |
| 输入价格 | 0.10 美元/百万 tokens | 1.25 美元/百万 tokens |
| 缓存输入价格 | 0.002 美元/百万 tokens | 0.15 美元/百万 tokens |
| 输出价格 | 0.20 美元/百万 tokens | 4.25 美元/百万 tokens |
| 每分钟请求上限 | 100 RPM | 3,000 RPM |
| 每分钟 tokens 上限 | 3,000,000 TPM | 4,000,000 TPM |
表中价格与额度来自 Meta Model API 官方计费页面,更新时间为 2026 年 9 月 23 日。额度按团队计算,不是每个 API Key 各有一份;在同一团队创建多个密钥不会成倍增加上限。
官方文档没有把 Contributor 描述成删减能力的轻量版。1.2 Contributor 与 1.2 标准版列出的上下文窗口、输入类型和输出类型相同,均面向编程、多模态理解、工具调用和长流程任务。
但“规格相同”不等于任何时候输出都逐字一致。推理服务本身可能存在非确定性,运行工具、提示词、推理档位和请求时的系统配置也会影响结果。比较两个档位时,应固定模型版本、提示词、工具、推理强度与输出上限,再对多次结果进行统计。
1.3 还有一个容易混淆的限制:官方文档把 max 推理档位标注为标准版专有。若项目依赖最高推理强度,不能只根据低价选择 1.3 Contributor。1.2 的选择重点则主要落在数据规则和调用额度上。
低价不是因为上下文更短,也不是因为模型参数更少。价差对应的是两项交换:
以一个月使用 1,000 万输入 tokens、200 万输出 tokens 为例,不考虑缓存与联网检索:
| 档位 | 输入费用 | 输出费用 | 合计 |
|---|---|---|---|
| Contributor | 1.00 美元 | 0.40 美元 | 1.40 美元 |
| 标准版 | 12.50 美元 | 8.50 美元 | 21.00 美元 |
这个例子只计算文本模型 tokens。启用联网检索时,每 1,000 次查询另收 2.50 美元;具体还会受到缓存命中率、失败重试和工具返回内容长度影响。
若输入内容本来就能够公开,比如公开文档、开源代码、通用教程或虚构测试数据,Contributor 能以较低成本验证功能。原型阶段往往要反复调整提示词和运行流程,较低单价能够扩大测试覆盖面。
不含内部资料的评测集、格式检查和回归测试适合使用 Contributor。团队能够用固定任务比较模型版本、提示词与推理档位,再把通过验证的配置迁移到标准版。
在临时项目、演示代码和无敏感信息的模拟环境中,Contributor 可承担代码生成、故障分析和界面还原任务。最好仍使用隔离目录,并限制能够执行的命令与外部访问范围。
产品描述草稿、公开信息分类和通用结构化整理等任务,若数据规则允许,能够利用较低的输入与输出费用扩大处理规模。上线前仍需计算每分钟 100 次请求是否满足峰值流量。
只要团队不能接受内容进入未来模型训练流程,就不应使用 Contributor。常见情况包括:
不要依赖“我在提示词里写了请勿训练”来改变服务档位规则。是否允许训练由所选模型 ID 与平台条款决定,不由自然语言指令决定。对数据边界没有把握时,应先使用标准版,并让负责合规与信息管理的人员确认。
接口地址和标准版相同,主要变化是模型 ID。使用兼容客户端时,将模型设置为:
muse-spark-1.2-contributor
请求仍通过 Meta Model API 的 Bearer token 验证。团队应在配置层集中管理模型名,不要把标准版与 Contributor 的选择散落在业务代码中。这样需要切换档位时,只改一处配置,并能在日志中清楚记录每次请求使用了哪种数据规则。
上线前能够检查四项内容:模型 ID 是否正确、输入是否允许参与训练、每分钟额度是否足够、坚控是否覆盖联网检索和重试。仅仅看到请求成功,并不能证明项目已经按预期档位运行。
新项目通常先测试 1.3 Contributor,因为 1.3 在长流程协作、指令保持和工具效率上有所提升。1.2 Contributor 仍适合需要完整音频理解的任务;官方提示 1.3 的音频支持当前并不完整,含音频请求可能出现质量下降。
已有 1.2 流程若结果稳定,没有必要只为版本数字立即迁移。能够选取一批真实任务,比较两个版本的成功率、总 tokens、工具调用次数和人工修正时间。确定新版本带来的收益后,再更新生产配置。
Muse Spark 1.2 Contributor 的价值很明确:它保留 1.2 的主要规格,用训练数据授权换取大幅降低的调用费用。它适合公开、可共享、低风险的原型和批量实验,不适合承载不愿进入训练流程的内部信息。选型时最先确认的不是便宜多少,而是数据是否允许这样使用。
Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]