

atlas:AI Agent 工具实践指南
2026-10-03
2026-10-07 0
在项目中评估docparse,可以先看清用途边界:自适应文档解析工具:通过初步诊断,为每一层选择最优的解析器组合,并与Primary+Patch进行融合,自适应文档解析。从文档与演示交付的使用方式看,内容结构和版式在转换后容易走样是采用前必须回答的问题。先拿一份结构复杂的真实文档完成转换更稳妥;过程中要观察标题层级、表格图片、字体版式和可编辑性,失败也应能解释原因。我会把它列入经常交付正式文档或演示稿的团队的候选清单,而不是仅凭项目介绍直接纳入生产。
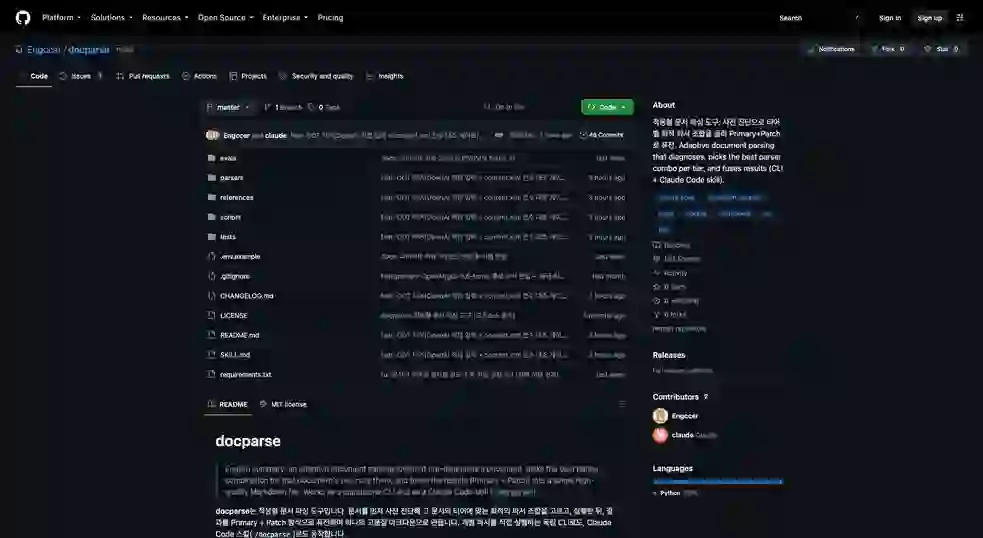
名称:docparse 描述:> 自适应文档解析工作流程。提前诊断文档以选择最佳的解析器组合, 与 Primary+Patch 方法有效融合,生成最高质量的单个降价。 触发条件: (1) 当您想要以最高质量解析文档时 (2) 当使用 /docparse 命令时 (3) 当尝试组合/融合多个解析器结果时 (4) 在 PDF、image、HWP、DOCX 等文档中。 提取文本时 元数据: 版本:“1.6.0”
docparse v3:自适应解析+Primary+Patch融合
提前诊断文档 → 选择最佳解析器组合 → 使用 Primary+Patch Fusion 生成高效、高质量的 Markdown。 LlamaParse v2(代理层)是中型~超大主级。
사용법
/docparse                       # 현재 디렉토리에서 파일 자동 탐색
/docparse input.pdf             # 파일 지정
/docparse input.pdf --lang en   # 비한국어 문서
参数解析:分隔空格→提取--lang <값>作为语言代码(默认ko)→剩余第一个token作为文件路径→如果没有路径,则自动在当前目录(Glob)中搜索支持的扩展。
패키지 구조
~/.claude/skills/docparse 符号链接指向的一个文件夹就是整个技能。运行时,该路径名为<스킬루트>。文件夹外的准备工作(pip包、Java、poppler以及转换HWP的hwpx-automation技巧)由README安装部分指导,每个解析器的准备状态由scripts/check_env.py检查。
파서 ( parsers/ )
| 脚本 | 功率输出 | API | 笔记 |
|---|---|---|---|
hwpx_local_parse.py |
_hwpxlocal.md |
无(本地) | HWPX 单一·免费·离线。 hwpx-tomd封装引擎(文本框、尾部、表格合并保存、自验证3种)。需要pip install hwpx-tomd。单词/字母回忆短缺/缺少标记警一进图就得把文档过一遍再出去。 HWP转换为hwp2hwpx后输入 |
xlsx_local_parse.py |
_xlsxlocal.md |
无(本地) | 仅XLSX·免费·离线·Non-LLM。单元格值、合并范围和状态都是隐藏文件中指定的格/,因此解析=读取。openpyxl开源文件XML 自省、和谐、多民族交流、国际交流、国际合作、国际合作 搬出去不容易,搬出去不容易,搬出去也不容易around.隐藏通知数据,为未计算的公式保留原始文本,并为单元格注释通知识/数量。图表/图像中的文本超出范围(警告) |
docx_local_parse.py |
_docxlocal.md |
无(本地) | 仅限DOCX·免费·离线·非LLM。按文档顺序提取正文(标题、文字、表格),填入document.xml python-docx中的盲点,例如文本框、字段和脚注,立即会被视为遗漏块并被拒绝(静默丢失阻止)。正式形式/ (OMML)、号字形和预算表格被拒绝,图像中的文本超出范围(聚合/警告,包括标题) |
pdfplumber_parse.py |
_pdfplumber.md |
无(本地) | 仅限规则表PDF(第0层)·免费·离线·非LLM。开门+PyMuPDF find_tables独立2引擎交叉投票(需要PyMuPDF,如果不则不创建输出),空单元格保存,结构上无幻觉/授权的更正。扫描(默认存在输出0),无行表格,单元格超出范围 |
upstage_parse.py |
_upstage.md |
UPSTAGE_API_KEY | 最强的噪音过滤,最高的完整性。使用 header/footer/page_number 删除的文本在标准输出上留下样本。 |
gemini_parse.py |
_gemini.md |
GEMINI_API_KEY | gemini-flash-latest(服务器别名,思维模型。由 check-stack-updates 监控的生成)。文本质量、复选框、韩文名称是最好的,但长文本存在摘要风险。默认为thinking_budget=0(反概括/忠实转录),开启为--thinking时,勾选/精读↑(小辅助用)。如果输出在令牌限制处被截断,则不会保存。只有小(≤15p)是初级的 |
llamaparse_parse.py |
_llamaparse.md |
LLAMAPARSE_API_KEY | v2 代理默认。表柱精度·OCR 优秀。 10 学分/页 |
mistral_parse.py |
_mistral.md |
MISTRAL_API_KEY | mistral-ocr-4。大规模完整性+ 标题结构生成(ocr-4 新),用于交叉验证。噪音·OCR 字符漂移·书写过度校正残留 |
opendataloader_parse.py |
_opendataloader.md |
无(本地) | 封闭式Java,仅限PDF,封闭式文档书 |
corepin_parse.py |
_corepin.md |
COREPIN_API_KEY | AI3 OSS引擎路由器(textPDF→opendataloader,HWP/HWPX→kordoc,Office→markitdown,扫描→AI3本身OCR)+韩国过滤器SLM。单张API 18种,每张2韩元。 已验证扫描形式的表结构是否丢失 → 主要不适合,用于辅助/比较使用 |
cohere_parse.py |
_cohere.md |
COHERE_API_KEY | parse-v5.0(Cohere Parse,2.3B VLM·8,192 个代币)。 Markdown + HTML 表格 + 图片描述。 韩语包含 9 种稳定支持的语言,$1.50/1,000 页(每月 1,000 次通话的免费试用密钥)。 ⚠端点仅接收图像,在PyMuPDF处渲染PDF,然后每页调用一次(页数=调用次数=费用)。每页输出达到 8,192 个 token 时可能会被切断,接近时请注意。 尚无实际评级 — 仅存在未分配等级的候选者 |
openai_parse.py |
_openai.md |
OPENAI_API_KEY | 基本型 gpt-5.6-terra(GPT-5.6 系列的中间层。--model gpt-5.6-luna 用于高容量和低成本,gpt-5.6-sol 用于最困难的扫描)。 OpenAI 没有专用解析器·OCR 端点 方法是将 PDF·image 插入 Responses API 并让通用多模态模型使用 markdown(失败模式与 Gemini 相同 — 长篇摘要)。因此,通过将 PDF 分为基本的 8 页部分(需要 --pages-per-call、PyMuPDF)来调用 PDF,并留下部分注释。 --effort·--detail·--verbosity 可调节。 Office (.docx·.pptx·.xlsx·.odt) 也被接受,但仅提取文本,因此它是本地确定性解析器拒绝/提升的候选者(不支持 HWPX)。 ODT没有本地解析器,因此该解析器排名第一(以一份官方文档实测:content.xml 68段全部保留,第一行混杂meta.xml dc:title通知,空单元格-被填充,支付表重新排列)。如果响应未完成(达到输出上限等),则不会保存。 只有一个实际测量的成绩,ODT — 仅作为候选人存在,除 odt 层级外没有其他层级分配 |
gvision_parse.py |
_gvision.md |
GOOGLE_VISION_API_KEY 或 GV_TOKEN+GV_PROJECT | 非LLM OCR +字面上值得信赖。仅适用于保留错误关键的文档,例如手写答案。自动校正、无人为错觉的单词文字提取、每页写入低置信度(<0.90)的→自主阅读视觉阅读目标。PDF 供使用PyMuPDF渲染,然后按页面调用。免费1,000便士/月。置信度调整验证。阅读顺序·表格是一个缺陷(v2控件) |
스크립트 ( scripts/ )
| 脚本 | 使用 |
|---|---|
check_env.py |
检查每个解析器的依赖包/API 密钥准备状态 + 密钥颁发 URL(首次运行/只读) |
assess_document.py |
文档预诊断(页数、文本层、tier、解析器推荐JSON + signals(PUA密度、拉丁比例、样本页)+rule_hints(tier-rules子句仅用于诊断)) |
compare_outputs.py |
解析器输出的比较(标题间隙、表格数量、实际字符数、融合策略+证据) |
normalize_odl.py |
ODL 自动输出清理(页面分隔符、图像标记缩写、h6标准化、标题提升、空行压缩) |
generate_alt_text.py |
自动生成替代文本,方便视障人士访问(PyMuPDF + Gemini Vision,详细介绍为韩语)。失败/未映射的占位符保留原始文本 + 退出代码 1 |
extract_vision_drafts.py |
级联步骤②:逐页提取英文草稿(包含拉丁文,不包含韩文的行)+低信任列表,从_gvision.md到draft_pNN.txt。克劳德修复登场 |
hwpx_enrich.py |
HWPX 确定性强化:到hwpx-tomd输出轮廓样式→#标题,删除~~·强调色<mark>(charPr),打印PDF实际页面``(对齐 pdftotext 页面文本和全局 LIS),仅通过段落级别的精确匹配来删除分隔符和标题的残余部分 |
apply_corrections.py |
原件更正清单CSV申请周期:以CSV申请并验证错别字、个人信息、注释规范化(文档、原页、原文、更正、类型、处理、依据),无需手动更正(0份原文错误、替换后残留检查、自动填充原页)。即使重新生成原始文件,也会使用相同的 CSV 获得相同的结果。 |
评估工具由
parser-eval技能管辖:对解析器进行比较和评分,并将判断留在账本中,score_transcription.py(CER/WER与原始相比的定量评分)和diff_fidelity.py(LLM ↔ OCR发散标记→视觉阅读目标)就在该技能中。 ⚠parser-eval是作者的本地技能,因此它不随 docparse 一起分发,并且并不存在于所有机器上 — 如果不存在,则使用 tier-rules 中指定的替代路径完成编写两个脚本的步骤。原来的解析方法和提示是docparse。
참조 ( references/ )
| 文件 | 扳机 |
|---|---|
tier-rules.md |
当需要除等级以外的批改规则时,例如扫描/手写/试卷/合并副本PDF。 每节中的근거:行表示规则的确定性(n=文档数) — n=1·미표기 如果规则与本文档不一致,则首先怀疑该规则。 |
handwriting-cascade.md |
忠实手写转录的最佳方法:Vision→Claude (Opus) 级联是冠军(~98.2% 原始比较)。模型对比(单曲:Opus>Sonnet +1.0%p / Cascade: +0.3%p,Gemma·Haiku 已消除)·干净的修复提示·速度。 5子集定性+3级锦标赛 CER/WER 定量 |
hwpx.md |
当HWPX·HWP文件(format为hwpx·hwp)时:加固·混合·上级交叉条件·发动机故障处理·HWP转换 |
handwriting-ocr-engines.md |
选用OCR引擎,忠实转录手写扫描文档(视觉比较·Azure·CLOVA·TrOCR·Tesseract等·语言·PII·成本) |
postprocess.md |
LlamaParse v2后处理正则表达式·ODL自动清理·第7步最终噪声清理 |
gotchas.md |
注意事项/错误处理/安装。当解析器失败或者结果很奇怪时 |
fusion-prompt.md |
全融合详细说明(如有重大重写) |
custom-prompts/accessible.txt |
将可访问性优先的解析指令注入llamaparse_parse.py --instructions |
파서별 특성 한눈 비교
| 解析器 | 合成 | 完整性 | 文本 | 标题 | 图形 | 限制 |
|---|---|---|---|---|---|---|
| hwpx_local (HWPX) | 一个 | A+(100% 字母和标记) | 一个 | B(与原文结构相同) | A(cellAddr/cellSpan格) | 仅 HWPX,图像中没有文字,布局是近似的 |
| xlsx_local (XLSX) | A(仅限XLSX) | A+(原为 XML 与 PASS 时间) | A+(人物含义,想象力0) | F(未创建) | A+(显式留留合并范围) | 仅限 XLSX。图表、图像中不允许出现文字,未计算的公式均用原文书写。 |
| docx_local (DOCX) | A(仅限DOCX) | A+(全段PASS) | A+(人物含义,想象力0) | A(与标题样式相同) | A(单元格,拒绝拒绝表格) | 仅限 DOCX。如果有文本框或脚注,图像中没有文本,则拒绝(提升) |
| pdfplumber(规则表) | A(目标偏差有限) | A+(细胞移植/空细胞保存) | A+(人物含义,想象力0) | F(未创建) | A+(自我报告/PASS 的2次绩效评估) | 仅规则+文本层。扫描输出 0、合并单元格/无衬线表格损坏、散文/标题超出范围 |
| 后台 | 一个 | A+ (100%) | 一个 | 一个 | 一个- | 同步100p限制,扫描OCR字段 |
| LlamaParse v2 | 一个 | 一个 | 一个 | A+ | A+ | 10 学分/页,1 次扫描手动表格栏移动 |
| OpenDataLoader | 一个- | A+ (100%) | B+ | B(h6趋势) | 一个 | PDF·仅有文字层,无图像描述 |
| 米斯特拉尔 | B+ | A+ (100%) | 一个- | B+(ocr-4标题生成) | 一个- | 需要对噪声进行后处理、OCR 字符漂移、笔迹校正过度 |
| 双子座 (latest/thinking) | B-(≤15p) | 小A / 长总结F | A+ | A+ | A+ 格式/C 热扫描(偏移残留) | 无长初级(摘要),仅限 ≤15p。复选框·韩文名A(思考ON辅助)。默认thinking_budget=0 |
| Cohere评测(解析-v5.0) | 未评级 | 未评级 | 未评级 | 未评级 | 未评级 | 原浮动汇率:0. 年初一前,中国市场 ParseBench 79.2 > Mistral OCR 4 74.5 没有)。未提供信。输入约束在上面的解析器表中 |
| OpenAI (gpt-5.6) | 未评级 | 未评级 | 未评级 | 未评级 | 未评级 | 实际测量值:0. 入市前,入市前。 )。适用于国际学生,用户,所以它具有与Gemini相同的结构性摘要风险,并且页面分Office仅支持文本,不支持HWPX)在上面的解析器表中列出。 |
| 谷歌视觉(书面) | A-(仅书写) | A(手写) | A(原件保存) | F(未创建) | C(不支持) | 提供每个单词的置信度(平均 0.95+,置信度低 ~7%,校准良好)。保存笔迹错误、幻觉0.阅读顺序打乱、复选框判断不稳定、云PII |
실행 워크플로우
步骤0:环境检查(首次运行或怀疑密钥/依赖项时)
python "<스킬루트>/scripts/check_env.py"
每个解析器的依赖包·API 一次性打印密钥准备状态和密钥发行 URL(只读,不安装任何东西)。如果这是第一个克隆环境或特定解析器由于缺少密钥或软件包而失败,请首先运行它以检查要安装和配置的内容。免费的本地解析器(hwpx_local·pdfplumber·xlsx_local·docx_local·opendataloader)无需密钥即可直接使用。并非每个任务都需要此过程,因此环境准备好后可以跳过此过程。
步骤0.5:浏览编辑源代码(必须在解析PDF之前完成)
如果您收到要打印或分发的 PDF,首先在下一个文件夹、共享驱动器或订购地点中查找同一文档 (HWP·HWPX·DOCX·XLSX) 的原始编辑。 如果是这样,请将文件发送到确定性层(hwpx·docx·xlsx)并将PDF发送到页面。仅用于编号和比较目的。在编辑后的原稿中,合并单元格、表格边框、格式(删除线、字体颜色)和标题级别均在 XML 中指定,因此从结构上消除了 LLM 解析器的三大错误(合并单元格制造、列拥挤和页面边框截断)。询问您是否有原件的成本就是一次答复。
第一步:预诊断
python "<스킬루트>/scripts/assess_document.py" "<파일경로>"
检查 JSON 中的 tier、pages、has_text_layer、table_hint、format → 确定每层的解析器策略。 table_hint: true 表示已检测到矢量规则网格,如果存在文本层,则 pdfplumber 出现在 recommended_parsers 的开头(步骤 2 第 0 层)。 没有文本层(扫描副本),tier 比页数层高一级(12 页扫描副本 → 中)。 recommended_parsers 是步骤 2 基本层表加上三处更正:扫描副本排除 ODL 并添加 Upstage·Mistral(诊断层大或更高 = 16 页或更多);如果 --lang 不是 ko,则添加 Mistral; docx·xlsx 在本地解析器之后添加了一个升级候选者(upstage·llamaparse)。由于hwp、pptx、images为表外格式,建议使用Upstage系列(HWP转换为references/hwpx.md后输入)。如果表格或更正发生变化,脚本也会发生变化。
signals 仅包含可确定性测量的内容:text_pages(示例页面中包含文本的页数。示例是前 3 页 + 分布在整个文档中的最多 12 页)、pua_per_10k(文本层每 10,000 个字符的 PUA 代码点。如果 ≥100,则公式试纸规则),latin_ratio(字符之间的拉丁比例。Mistral 主要考虑条件如果≥0.5)。 rule_hints 是 tier-rules 子句的名称(或子句要点的一行),仅由诊断确定。为空并不意味着“不适用”,而是意味着“尚有条款无法诊断确定”。手写、组合抄写、合并单元格、人口统计交叉表等由座席直接从第2步修正规则列表中判断。
第 2 步:选择自适应解析器
기본 티어 표
| 层 | 状况 | 解析器策略 | 小学 |
|---|---|---|---|
| t0 | PDF + 文本层 + 规则网格(table_hint) + 目标输出为表格数据 |
pdfplumber (本地/免费) 之前打开,如果自我验证/交叉投票失败,则提升到以下级别 | 水处理工人.pdf |
| hwpx | HWPX 文件 | hwpx_local (本地/免费) 之前,当图像/布局很重要时交叉/替换Upstage | hwpx_local |
| xlsx | XLSX 文件 | xlsx_local (本地/免费) 一、如果验证失败/图表文字很重要后台·LlamaParse | xlsx_local |
| 文档 | DOCX 文件 | docx_local (本地/免费) 一、被拒绝时(文本框、脚注等),Upstage·LlamaParse | 文档本地 |
| ODT | ODT 文件 | OpenAI 可以入境。 Pandoc(缺表格/顶部/底部信息),将结果与段落content.xml进行充分比较 | 开放性 |
| 小 | PDF≤15p | 双子座鞋底 | 双子座 |
| 中 | PDF 16~60p | LlamaParse v2 + 后台 | LlamaParse v2 |
| 大 | PDF 61~100p | LlamaParse v2 + ODL | LlamaParse v2 |
| 超大 | PDF 101p+ | LlamaParse v2 + ODL | LlamaParse v2 |
页数从小到大是根据文本层所在的PDF计算的。扫描遵循步骤 1 中的较高层和层规则的“无文本层”部分。
第 0 层(决定论优先级门):table_hint: true(矢量规则网格)+ has_text_layer: true,并且如果目标输出是表格数据而不是散文(管理文档,例如时间表、公告牌、统计表和每周学习指南),则页数层优先。尝试 pdfplumber_parse.py(本地、免费、非 LLM)。这是因为当来源明确时(绘制的网格+嵌入的字母),LLM 的推论是纯粹的下行风险。 Grid↔坐标自验证和PyMuPDF独立双引擎交叉投票机器比较单元位置。
_fused_v3_pdfplumber.md) 并省略步骤 5 和 6(完整性门/交叉验证)。步骤7 进行最终检查。--strategy text来尝试无规则排序表,PASS的含义最多为“单词保存+2引擎结构收敛”。references/tier-rules.md的“格线格式表PDF”部分。HWPX·HWP:如果format是hwpx·hwp,则读取references/hwpx.md(hwpx_local优先级基础,确定性强化,草案HWP +打印PDF 混合、后级交叉条件、发动机故障处理、HWP 转换)。
Office 本地层 (XLSX·DOCX):XLSX·DOCX 是一种在文件 XML 中指定单元格值、合并范围和标题样式的格式,因此按原样应用第 0 层哲学(如果来源明确,LLM 推理存在下行风险)。先写xlsx_local_parse.py(openpyxl +原始XML值多重集交叉验证)和docx_local_parse.py(python-docx + document.xml全回忆比较),如果PASS就照原样(_fused_v3_xlsxlocal.md/_fused_v3_docxlocal.md,步骤5和6省略,步骤7进行最终检查)。如果被拒绝(验证不匹配、文本框、脚注、嵌套表),则升级为 Upstage·LlamaParse。基础和边界在层级规则「XLSX·DOCX」部分。
ODT:没有本地解析器,只有一个已确认接受的云端解析器,OpenAI,因此不存在交叉验证伙伴。而是将原始content.xml的非空终端text:p段落进行空间归一化,并与输出完全进行比较(段落内容、表格单元格对应、阅读顺序,甚至重复),如果PASS,则采用为_fused_v3_openai.md。此排序规则取代了步骤 5 和 6,并且步骤 9a 中的“第三类型解析器”请求不适用(如果需要视觉阅读,请将 PDF 转换为 LibreOffice,然后阅读)。将 dc:title 通知合并到第一行、用 - 填充空单元格以及支付表的重新排列不会通过排序规则捕获,因此请参阅步骤 7。基础和边界是分层规则“非 PDF 文档格式的解析器选择”行 ODT。
初级选择原则:选择缺陷少且无法自动化纠正的解析器作为初级。 LlamaParse v2 最适合中型到大型(目录组织良好、表格列准确、0 噪音、LaTeX 0)。当信用不足时,回退到 ODL 主要 + 后台交叉验证(当有文本层时。扫描副本具有分层规则“无文本层”)。 Mistral ocr-4 生成标题结构,是 textPDF 后备的主要候选者,但噪声和 OCR 字符漂移的后处理是前提(层规则“Mistral ocr-4 标题生成”)。
Small Tier Gemini Note(最初的 Gemini 规则。其他文档中的 Gemini 描述遵循本节):gemini-flash-latest 是指向思维模型(由 check-stack-updates 监控的生成)的服务器别名。当思维开启时,长文本(≳20p)进入摘要而不是转录,悄悄地丢弃正文并将其伪装成完整的文档(基于gotchas.md)。为了防止这种情况,gemini_parse.py被忠实地转录为默认thinking_budget=0 + max_output_tokens=65536。 请勿将 Gemini 用作长主(仅限小 ≤15p)。但如果关闭思考,手写复选框的读取就会变弱,所以对于复选框、韩文名字等需要精确读取的辅助补丁,将其打开,并用gemini_parse.py <파일> --thinking单独调用。
보정 규칙 (티어 결정 후 적용)
这就是references/tier-rules.md的整个判断部分。 一个文档同时卡在多个子句中是正常的,冲突可以通过层级规则开头的“规则优先级”解决(格式门 > 禁止 > 添加必填 > 推荐)。从上到下浏览下面的列表 为每个条款勾选“适用/不适用”,并仅写出第 8 步摘要中适用的条款(未列出的条款必须已被判断为不适用,而不是不被判断)。 assess_document.py的rule_hints自动捕获的子句用◇标记。
--lang≠ko)references/hwpx.md)第 3 步:运行解析器
仅并行执行选定的解析器。 xlarge 的时间限制为 600 秒,其他为 300 秒。使用 < /dev/null 阻止交互式提示。如果--lang不是ko,它也被传递到llamaparse_parse.py(--lang <코드>)·gvision_parse.py(--lang <코드>,ko逗号列表)。
执行契约:仅当创建输出文件时,所有解析器退出代码0。错误/空结果/验证失败/部分结果(Gemini 令牌截断、Upstage 放置缺失、Mistral 页数不匹配、Vision 页面调用失败/上一页结果为空)以 1 结尾且没有输出,并且在执行开始时,首先删除以前的同名输出。因此,在继续步骤 4 之前,检查退出代码和输出文件是否存在。如果退出代码非零并且文件存在,则该文件不属于本次运行。
下面的示例基于 bash (Git Bash·Linux)。
timeout 命令,因此如果按原样键入它,将导致退出 127,并且解析器甚至不会运行。如果coreutils中有gtimeout,则将其替换为timeout。如果没有,则不运行timeout N,然后手动关闭超过时间限制的解析器。$null,因为没有 暂停·< /dev/null·&·等待 | python ...关闭标准输入 Start-Job/Start-Process -Wait 或者用顺序执行代替。# medium 티어 예
timeout 300 python <스킬루트>/parsers/llamaparse_parse.py "<파일경로>" < /dev/null &
timeout 300 python <스킬루트>/parsers/upstage_parse.py "<파일경로>" < /dev/null &
wait
# xlarge 티어 예
timeout 600 python <스킬루트>/parsers/llamaparse_parse.py "<파일경로>" < /dev/null &
timeout 300 python <스킬루트>/parsers/opendataloader_parse.py "<파일경로>" < /dev/null &
wait
# t0 티어 예 (괘선 표 PDF, 로컬·무료·1초 내외. PASS/경고를 표준 출력으로 보고)
timeout 300 python <스킬루트>/parsers/pdfplumber_parse.py "<파일경로>" < /dev/null
# 괘선 없는 정렬 표(opt-in): text 전략 + 2엔진 교차 투표
timeout 300 python <스킬루트>/parsers/pdfplumber_parse.py "<파일경로>" --strategy text < /dev/null
# xlsx·docx 티어 예 (로컬·무료. PASS/거부를 표준 출력으로 보고)
timeout 300 python <스킬루트>/parsers/xlsx_local_parse.py "<파일.xlsx>" < /dev/null
timeout 300 python <스킬루트>/parsers/docx_local_parse.py "<파일.docx>" < /dev/null
# hwpx 티어 예 (로컬·무료 우선; 긴 지문이 셀 안에 있으면 --cell-br)
timeout 300 python <스킬루트>/parsers/hwpx_local_parse.py "<파일.hwpx>" < /dev/null
# 이미지 경고·recall 경고가 뜨거나 레이아웃이 중요하면 Upstage로 교차검증
timeout 300 python <스킬루트>/parsers/upstage_parse.py "<파일.hwpx>" < /dev/null
辅助功能优先解析(残疾人和视障用户文档的信息材料)添加了 --instructions <스킬루트>/references/custom-prompts/accessible.txt 并注入 v2 agentic_options.custom_prompt。 只有一个选项名称,--instructions。对于其他名称(--custom-prompt-file、--prompt 等),参数解析器将该值识别为第二个输入文件,并将accessible.txt 单独发送到LlamaParse,因此实际上并未应用custom_prompt。
第 4 步:创建主要基地
最终输出文件名规则(文件名揭示了哪个解析器被集成到 fused 中):
<파일명>_fused_v3_<파서조합>.md。<파서조합> 只列出其内容实际上反映在该结果中的解析器,从 Primary 开始,并以 + 继续。不包括仅执行简单比较且不合并文本的解析器(因为文件名是“合并内容”的记录)。llamaparse·upstage·gemini·mistral·opendataloader·hwpxlocal·pdfplumber·xlsxlocal·docxlocal·corepin·gvision·cohere·openai._fused_v3_llamaparse+upstage.md,如果仅采用Mistral,则为_fused_v3_mistral.md,如果仅采用hwpx_local,则为_fused_v3_hwpxlocal.md。+<파서> 来重命名它。LlamaParse v2 主要
cp "<파일명>_llamaparse.md" "<파일명>_fused_v3_llamaparse.md"
通过简单地组织图像占位符,可以立即将基于文本的文档(法律、论文、报告)进行融合。 可打印的小册子、图表丰富的文档(信息图表、章节封面、标题内嵌图标等)应用 references/postprocess.md v2 的 7 种后处理模式。
⚠ 不要简单地去掉图片占位符:即使在学术报告中,也混杂着1-2个文本信息图。首先用generate_alt_text.py创建一个富含韩语的alt,然后去掉封面、标志和设计标签,以(이미지: 的形式保持文本信息图内嵌。
python <스킬루트>/scripts/generate_alt_text.py \
    --pdf "<파일>.pdf" --markdown "<파일>_llamaparse.md" \
    --output "<파일>_with_alt.md" --map "_work-docparse/<파일>_alt_map.json"
检查创建的 alt 并仅将正文图内嵌插入 fused 中。标志和徽标被删除。
ODL 主要(后备)
python <스킬루트>/scripts/normalize_odl.py "" "<파일명>_fused_v3_opendataloader.md"
自动处理项详情请参见references/postprocess.md。由于图像占位符不会被删除,而是保留为 (이미지: alt)/(이미지) 标记,因此在步骤 7 中使用与上面的 LlamaParse 项目相同的标准对其进行组织(保留人体图并删除装饰)。
⚠ ODL 采用前需要进行主要正文编号验证(即使是文本层):当出版物嵌入字体的字形映射被破坏并且 ODL 省略所有正文编号/特殊字符时,就会存在这种情况。立即将正文第一段中的 1-2 个数字与 v2/Upstage 进行比较。如果丢失,则丢弃 ODL Primary。详细信息:references/tier-rules.md。
第 5 步:数据完整性门
必须在选择Primary之后、LLM交叉验证之前立即执行。 在表格中有数字数据的文档中不能省略。 但是,在按原样采用局部确定性解析器(Tier 0·XLSX·DOCX·HWPX)的PASS并且ODT的content.xml完全比较PASS的情况下,不适用,因为验证替换了该门。
개별항목 합 == 소계等)。成本0。⚠ 仅通过算术验证无法检测到热运动。 步骤 5.3 单元位置比较是唯一的防线。
第6步:LLM交叉验证和修补
6a。标题间隙补丁
python <스킬루트>/scripts/compare_outputs.py "" ""
仅从 Upstage 读取有间隙的标题部分并将其插入到编辑中。
6b.文本/数字交叉验证
将当前融合文件 (_fused_v3_<파서조합>.md) 的 3 到 5 个代表性部分(开始、中间、表密集部分和结束)与辅助解析器输出进行比较。如果辅助解析器更准确,则替换它,如果两者不同且无法确定,则添加 Mistral(如果您已经听过,请目视阅读)。 LlamaParse v2 元数据遗漏倾向(打印机、电子签名者、原始验证完成等管理元数据)在Upstage中补充。 如果辅助解析器的文本实际上已被反映(替换/修补),则通过将解析器添加为 +<파서> 来重命名文件名 <파서조합>(步骤 4 命名约定)。
6c。表数据一致性
对于表格中包含数字数据的文档来说是必需的。如果步骤 5 中的一种情况存在差异,则通过额外执行 Mistral 来进行 3 路交叉(如果您已经听过,请目视阅读)。
第 7 步:最终噪声清除
最终融合文件的最终检查 (_fused_v3_<파서조합>.md)。 不要随意更正原文中的错别字:LLM解析器悄悄更正的符号(「垃圾→垃圾桶」「构造→构造」)通过三字比对返回原文,如果需要更正,则通过apply_corrections.py的更正列表CSV。 OCR 伪影(一、□)、页面边框孤立线、重复标题、幻觉文本、图像占位符残留、后台 OCR 字段、HTML 复选框伪影、重复页脚等。有关详细清单,请参阅 references/postprocess.md 步骤 7 部分。
第 8 步:打印并整理
原理:最终结果(_fused_v3_<파서조합>.md)保留在工作文件夹中,而到目前为止的副产品(单独的解析器输出)则隔离在 _work-docparse/ 子文件夹中。文件夹名称揭示出处(docparse)+性质(工作=中间工作),后缀规则与hwpx-automation技能的_work-hwpx-automation/统一。
[파일명]_fused_v3_<파서조합>.md(有关解析器组合命名约定,请参阅步骤 4)。 在保存之前,检查文件名中的解析器列表是否与实际反映内容的解析器匹配(我只使用了 Primary 并反映了 secondary 解析器,以免省略重命名)。_work-docparse/ 子文件夹:mkdir -p "<파일 디렉토리>/_work-docparse"
mv "<파일명>_llamaparse.md" "<파일명>_upstage.md" "<파일 디렉토리>/_work-docparse/"
# 如果使用,_gemini.md、_mistral.md、_opendataloader.md、_hwpxlocal.md、_pdfplumber.md、
# 同时移动 _xlsxlocal.md、_docxlocal.md、_gvision.md、_corepin.md、_cohere.md、_openai.md、_with_alt.md
# (로컬 티어 단독 채택이면 그 출력을 _fused_v3_<토큰>.md로 채택)
步骤9:后期处理:额外的交叉验证回顾+学习反思(不可省略)
工作并没有随着融合输出而结束。在每次解析操作结束时,都会执行以下两个过程,并将结果逐行包含在步骤 8 的摘要输出中。
9a。审查是否需要额外的解析器进行交叉验证。 如果出现以下任一情况,则执行额外的解析器(主要是 Mistral,视情况而定,ODL·Gemini),并由三方投票得出结论。如果不适用,请在摘要中注明“额外的交叉验证:不需要”并说明理由。
| 扳机 | 附加解析器 | 原因 |
|---|---|---|
| 两个字符解析器之间的不一致问题仍未解决(日期、专有名词、正确答案等) | 米斯特拉尔(或 PDF 视觉阅读) | 以 2:1 多数投票 + 原始确认结束。不要将问题保留为“[OCR 不确定]” |
| 非韩语/混合语言材料 | 米斯特拉尔 | 参见层级规则“完善非韩语条件”:扫描+拉丁语外语为第一层,文本层韩语混合用于投票 |
| 准确性至关重要(试卷、法律、病历),但解析为 2 种或更少类型(采用局部确定性解析器 PASS,ODT content.xml 对比 PASS 除外) | 第三类解析器 | 三路等级规则 |
| 报告附录中前所未有的新文档类型 | 添加了 1 种类型 | 解析器性能数据收集和执行(附录中的新材料) |
| 在LLM·OCR的解析器输出中,在原文中发现了一个可疑的拼写错误。 | 类型 1 添加或视觉阅读 | 如果有3个字符匹配,则记录为“原始拼写错误已确认” |
9b.反思学习。 如果通过验证发现新的可重用模式,则立即反映在相应的规则文档中,防止下一个任务重复相同的试错:
references/tier-rules.md 更新 + 反映了 SKILL.md 解析器比较表。references/postprocess.md。references/gotchas.md。根据发现的规模,向现有规则或案例添加新规则或案例。影响用户的更改在 CHANGELOG.md 中记录为日期条目,并在 SKILL.md metadata.version 中引发(操作更改次要,表达式补丁)。
환경 변수
| 多变的 | 必需的? | 笔记 |
|---|---|---|
LLAMAPARSE_API_KEY |
中级或更高(小学) | LlamaParse v2 代理。 10 学分/页 |
UPSTAGE_API_KEY |
中·扫描件(交叉验证),HWPX·Office促销 | 完整性和元数据补充 |
GEMINI_API_KEY |
小层/替代文本创建 | ≤15p 主要或 generate_alt_text.py |
MISTRAL_API_KEY |
有条件(不匹配/非韩语/扫描 16 页或更多) | 用于3方交叉验证 |
COREPIN_API_KEY |
有条件(HWP 母语/韩语文档比较) | 芯销制造设备 |
GOOGLE_VISION_API_KEY |
有条件(手写答案) | 视觉解析器身份验证(APIK)。或GV_TOKEN(=gcloud auth print-access-token)+GV_PROJECT。需要激活Vision API |
COHERE_API_KEY·OPENAI_API_KEY |
运行候选解析器比较时 | 未评级候选人 |
| Java运行时 | 大或更大(ODL),转换为HWP | 对于OpenDataLoader·hwp2hwpx |
变量列表的原始版本是.env.example,就绪检查是scripts/check_env.py(步骤0)。
변경 이력
CHANGELOG.md(存储库根)
Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]