

平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“grep文本搜索与正则表达式完整代码示例”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
一、grep
从实现思路看,grep 是 Linux/Unix 系统中的一个命令行工具,用来从文件中搜索文本或字符串。能够采用正则表达式搜索文本,同时把匹配的内容所在行输出。
◆ grep 通用正则表达式分析程序(global search regular expression and printing)
用途:采用正则表达式搜索文本,并把匹配的行打印出来。
格式:grep [选项]… 模式 目标文件 -->(更节约性能)
命令 | grep [选项]… 模式
[root@localhost shell]# grep root /etc/passwd
root:x:0:0:root:/root:/bin/bash
operator:x:11:0:operator:/root:/sbin/nologin
-o:仅显示匹配的内容
[root@localhost shell]# grep -o "root" /etc/passwd
root
root
root
root
-i:不区分大小写
[root@localhost shell]# grep -i aaa test1.txt
aaa AAA bbb BBB #!@### abc
aaa AAA ccc123 bbb BBB #!@### abc
aaa AAA ccc123 bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
-n:显示行数
[root@localhost shell]# cat test1.txt |grep -i -n "123"
2:aaa AAA ccc123 bbb BBB #!@### abc
3:aaa AAA ccc123 bbb BBB #!@### abc
-v:反转查找,输出与模式不相符的行
[root@localhost shell]# cat test1.txt |grep -i -n -v "123"
1:aaa AAA bbb BBB #!@### abc
4:aaa AAA bbb BBB #!@### abc
5:aaa AAA bbb BBB #!@### abc
-An:同时显示符合条件行的下面 n 行
[root@localhost shell]# cat test1.txt |grep -A2 "www"
aaa AAA www888 ccc123 bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
-Bn:同时显示符合条件行的上面 n 行
[root@localhost shell]# cat test1.txt |grep -B2 "www"	显示匹配行及上面2行
aaa AAA bbb BBB #!@### abc
aaa AAA ccc123 bbb BBB #!@### abc
aaa AAA www888 ccc123 bbb BBB #!@### abc
-Cn:显示匹配行及上下各 n 行
[root@localhost shell]# cat test1.txt |grep -C2 "www"
aaa AAA bbb BBB #!@### abc
aaa AAA ccc123 bbb BBB #!@### abc
aaa AAA www888 ccc123 bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
-E:兼容扩展正则表达式,等同于egrep
[root@localhost shell]# cat test1.txt |grep "aaa|bbb"
[root@localhost shell]# cat test1.txt |grep -E "aaa|bbb"
aaa AAA bbb BBB #!@### abc
aaa AAA ccc123 bbb BBB #!@### abc
aaa AAA www888 ccc123 bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
[root@localhost shell]# cat test1.txt |egrep "aaa|bbb"
aaa AAA bbb BBB #!@### abc
aaa AAA ccc123 bbb BBB #!@### abc
aaa AAA www888 ccc123 bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
aaa AAA bbb BBB #!@### abc
用 egrep "^[rmf]" /etc/passwd 比 cat /etc/passwd|egrep "^[rmf]" 要好,更节约性能。
二、正则表达式
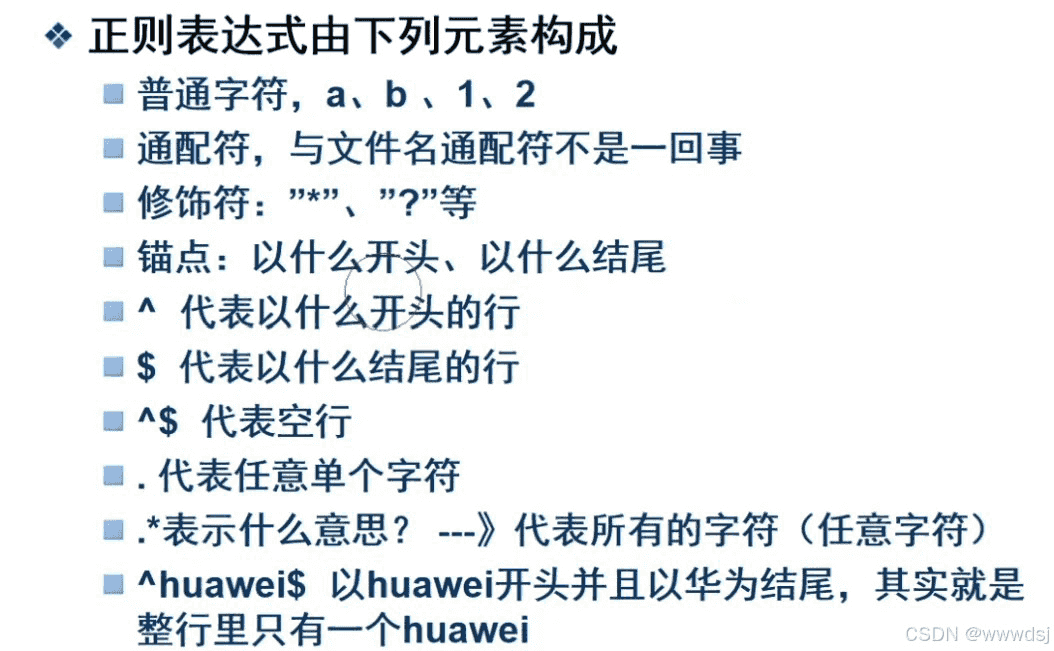
正则表达式:采用一些特殊符号+字母+数字按照某个正确的规则组合成一个公式用来表达某个意思。
特殊符号:元字符(meta character) 作用:用来描述其他字符。
1. 通用修饰符
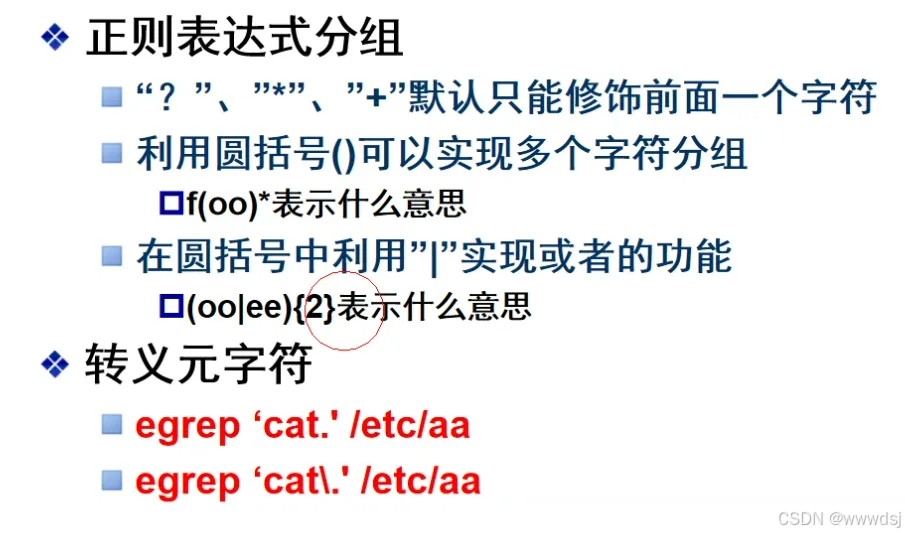
- “?”:表示 0 个或者 1 个前面的字符
- “*”:表示 0 个或者多个前面的字符
- “+”:表示 1 个或者多个前面的字符
- {n}:表示 n 个前面的字符
- {n,m}:表示 n 个到 m 个前面的字符
- “.”:表示一定有一个任意字符
- .*:表示匹配任意长度的任意字符
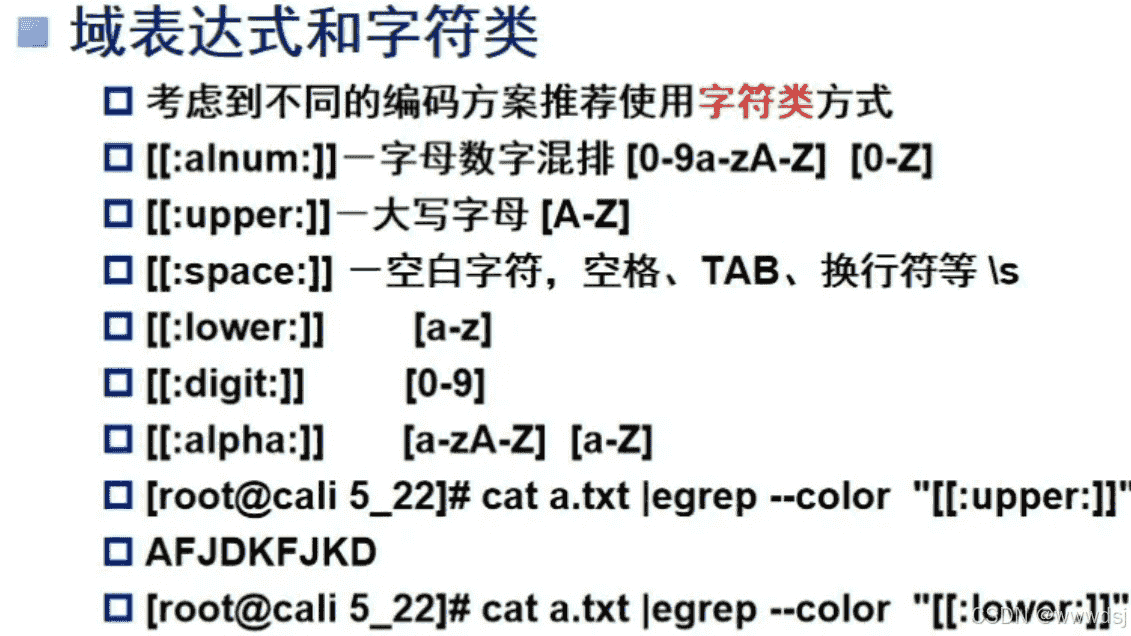
方括号表达式:一个文字字符域。[0-9]、[a-z]、[A-Z]
2. 描点搜索
“^”:表示以什么开头的行
grep -v '^#' /etc/inittab | grep –v ^$
egrep '^[^[:digit:]]' /etc/inittab
“$”:表示以什么结尾的行
egrep ':$' /etc/inittab
egrep '^hello$' file
- \<:表示词首部 --->\b
- \>:表示词尾部 --->\b
- \
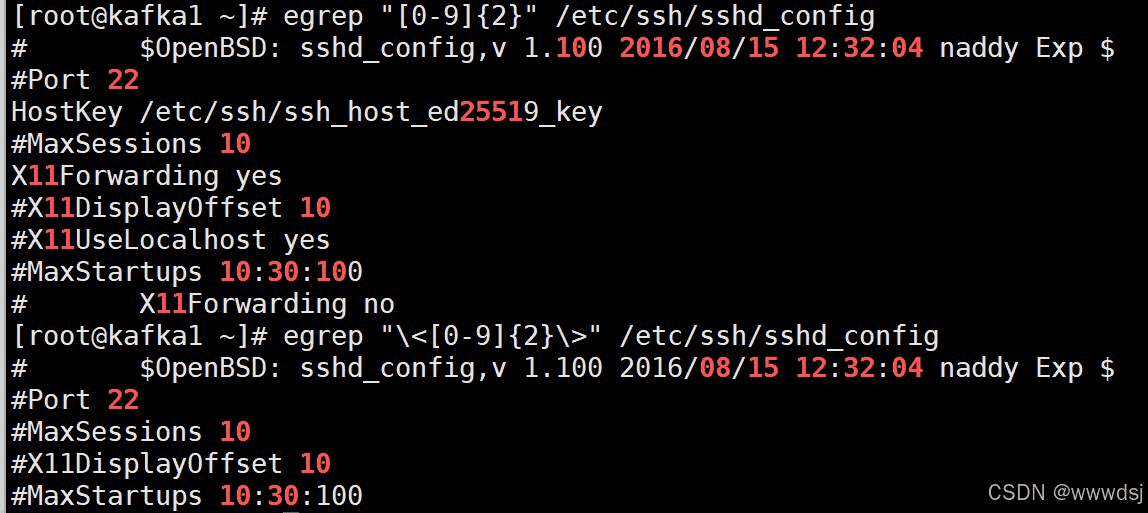
在正则表达式里,^[^[:digit:]] 是一个组合模式,用来匹配 不以数字开头 的字符串
^是一个锚点(anchor),表示匹配字符串的开头。[^...]是一个否定字符类,表示匹配不在括号内的任何字符。- 比如:
[^abc]表示匹配除了a、b、c之外的任意字符。
[:digit:]是一个 POSIX 字符类,表示匹配任意数字字符(等价于[0-9])。
3. 补充与事例
[root@localhost shell]# cat test1.txt |egrep "123\sbbb"		\s表示单个空格
aaa AAA ccc123 bbb BBB #!@### abc
aaa AAA www888 ccc123 bbb BBB #!@### abc
[root@localhost ~]# egrep "^[rmf]" /etc/passwd	找出以r或m或f开头的行
root:x:0:0:root:/root:/bin/bash
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
ftp:x:14:50:FTP User:/var/ftp:/sbin/nologin
mysql:x:997:995:MySQL server:/var/lib/mysql:/sbin/nologin
显示该文件中的有效行(不是#开头且不是空行且不是空格开头后有#):
[root@localhost ~]# egrep -v "^#|^$|\s+#" /etc/login.defs
MAIL_DIR	/var/spool/mail
PASS_MAX_DAYS	99999
PASS_MIN_DAYS	0
PASS_MIN_LEN	5
PASS_WARN_AGE	7
UID_MIN                  1000
UID_MAX                 60000
SYS_UID_MIN               201
...
理解这一步时,选出用户名含有www且采用bash的用户,.*表示匹配任意长度的任意字符:
[root@localhost ~]# egrep ".*www.*:x.*bash$" /etc/passwd
www2:x:1004:1004::/home/www2:/bin/bash
www1:x:1005:1005::/home/www1:/bin/bash
正则表达式筛选ip(0-255):
[root@localhost ~]# ip a|egrep "([0-9]|[1-9][0-9]|1[0-9][0-9]|2[0-4][0-9]|25[0-5])(\.([0-9]|[1-9][0-9]|1[0-9][0-9]|2[0-4][0-9]|25[0-5])){3}"
    inet 127.0.0.1/8 scope host lo
    inet 192.168.10.134/24 brd 192.168.10.255 scope global dynamic ens33
总结
在这个场景下,总的来说,grep搜索文件内容适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。