

Kimi K3 在真实 Astro 项目中的代码审查能力如何?
2026-10-27
2026-10-30 0
用 Opus 5.5 时,不必把 effort 一直开到最高。从默认的 medium 开始,先看结果是否合格;任务明确又简单,可以试 low;遇到确实需要多步推理的问题,再逐级提高。
effort 可以把它看成模型在回答时愿意投入多少思考和生成资源。它不是“准确率百分比”,也不是保证花费固定时间的开关。
Opus 5.5 支持 low、medium、high、xhigh 和 max。默认是 medium。
| 档位 | 简单理解 | 本文建议先测试的任务 |
|---|---|---|
| low | 更节省,较快处理 | 简短改写、明确字段提取 |
| medium | 质量、时间和费用之间取平衡 | 日常分析、一般代码修改 |
| high | 为复杂问题投入更多 | 多条件比较、困难故障定位 |
| xhigh | 面向更难、更长的工作 | 复杂迁移、长流程排查 |
| max | 为最高能力投入更多资源 | 高价值难题的小范围验证 |
表中的任务分配是实用起点,不是保证,也不是所有应用通用的默认配置。不同平台可能不展示所有档位。
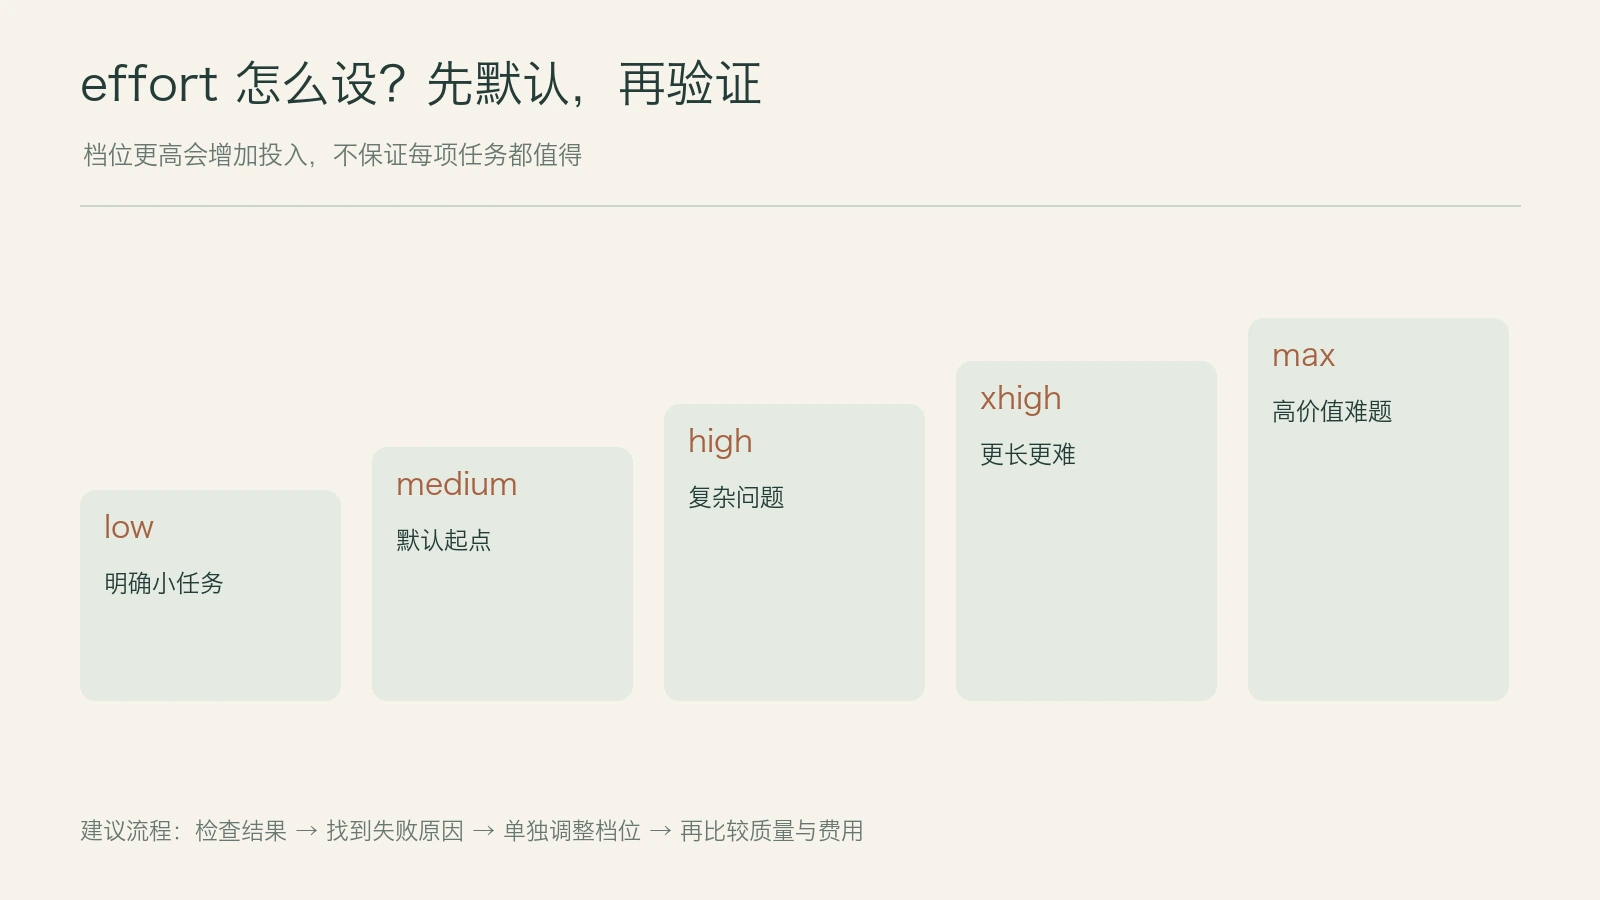
图:先在默认设置下核对结果,再有依据地升降档位。
不会。Opus 5.5 始终使用自适应思考,不能通过设置 low 把它改成完全不思考,也不能继续使用关闭思考的旧参数。
如果只想减少输出长度,应直接说明“只输出三个要点”或给出固定字段。调低 effort 主要用于减少处理消耗,不是精确控制字数。
同样,max 也不是越详细越正确。问题本身缺少数据,开高档位不能补回不存在的资料。
先试 low,再检查是否遗漏约束。例如要求把五条记录整理成统一字段,检查五条是否齐全、字段是否正确、没有的信息是否标空。
如果这个任务能用脚本稳定完成,也可以直接用脚本,不一定需要高档位模型。
从 medium 开始。把输入材料、要改的行为和检查方法写清楚,再看结果有没有经过验证。
如果任务失败的原因是缺文件或没有运行环境,先补材料和工具。只有在材料完整、工具正常,但模型仍然推理或判断不够时,提高 effort 才更有针对性。
可以在 medium 的结果基础上试 high,重点看质量有没有改善。例如是否找到了跨多个文件的原因,是否识别互相冲突的条件。
提高档位时保持同一份材料和完成要求,才能判断差异。不要同时改提示词、换工具、加资料,再把所有改善都归给 effort。
先把任务拆成阶段,做好进度记录,再比较 high 或 xhigh 是否值得。长时间运行还受工具、权限、上下文和程序管理影响,不是一个档位能解决所有问题。
max 可以留给高价值、确实难以解决的部分。先小范围看质量收益,再决定是否用于整个流程。
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=8192,
    output_config={"effort": "medium"},
    messages=[{"role": "user", "content": "分析这两个方案的取舍。"}],
)
这里假设已经创建 client。max_tokens 是本轮思考和输出的总预算上限,8192 只是示例。提高 effort 却保留过小预算,可能导致回答在完成前被截断。
在 Claude Code 中,可查看当前版本提供的 /effort 或模型设置入口,确认实际生效的档位。组织也可能限制最高档位。
选 10 项真实任务,分成简单、常见和复杂三类。先用 medium 跑一遍,记录结果是否合格、完整用时、计费输出和返工时间。
对简单任务,再试 low;对复杂且未达标的任务,再试 high。只有当质量确实提高,才继续测试更高档位。
可以用“合格结果比例”作为第一项指标,再比较每个合格结果的费用和时间。一个档位回答很长,但修改后才能用,不一定比短而准确的结果划算。
输入里有多个旧版本,先整理版本。模型不知道怎么查原文,先提供索引。需要运行测试但工具不能执行,先解决运行环境。
如果报参数错误,先看模型和 SDK 支持情况。遇到 429 或临时服务错误,也不应先通过调高 effort 来解决。
在同一类任务上连续测试,确认 更低档位 下结果仍然合格,再逐步降低。这里需要真正检查质量,不能仅凭回答看起来流畅。
对自动批处理,建议保留抽查和升级通道:简单任务低档处理,不符合标准的任务再进入更高档位或人工检查。
effort 的用途,是让同一个模型更贴合任务成本。先整理好问题和材料,再用实际结果决定档位,通常比始终开到 max 更方便控制时间与费用。
Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]