

使用C#代码设置Excel行高和列宽实用指南
2026-10-24
2026-10-30 0
Opus 5.5 支持 100 万 token 上下文,常规单次最大输出是 12.8 万 token。先记住:100 万是本轮能参考和生成内容的总容量,12.8 万是常规输出上限,两者都不能直接换算成固定的汉字数。
把一整本资料上传成功,也并不表示模型一定能准确回答其中所有细节。想真正用好长上下文,需要同时算容量、留输出空间,并把材料整理成容易查找的样子。
可以把上下文理解成这次工作摆在桌上的全部材料。它通常包括系统要求、你发来的问题、保留的聊天记录、工具说明,以及工具读取出来的文件和结果。本轮新生成的回答和思考也需要空间。
所以,“这份文档只有 80 万 token”还不足以判断能不能继续。假设文档占 80 万,其他输入占 5 万,本轮还想生成较长内容,就要把这些部分一起考虑。
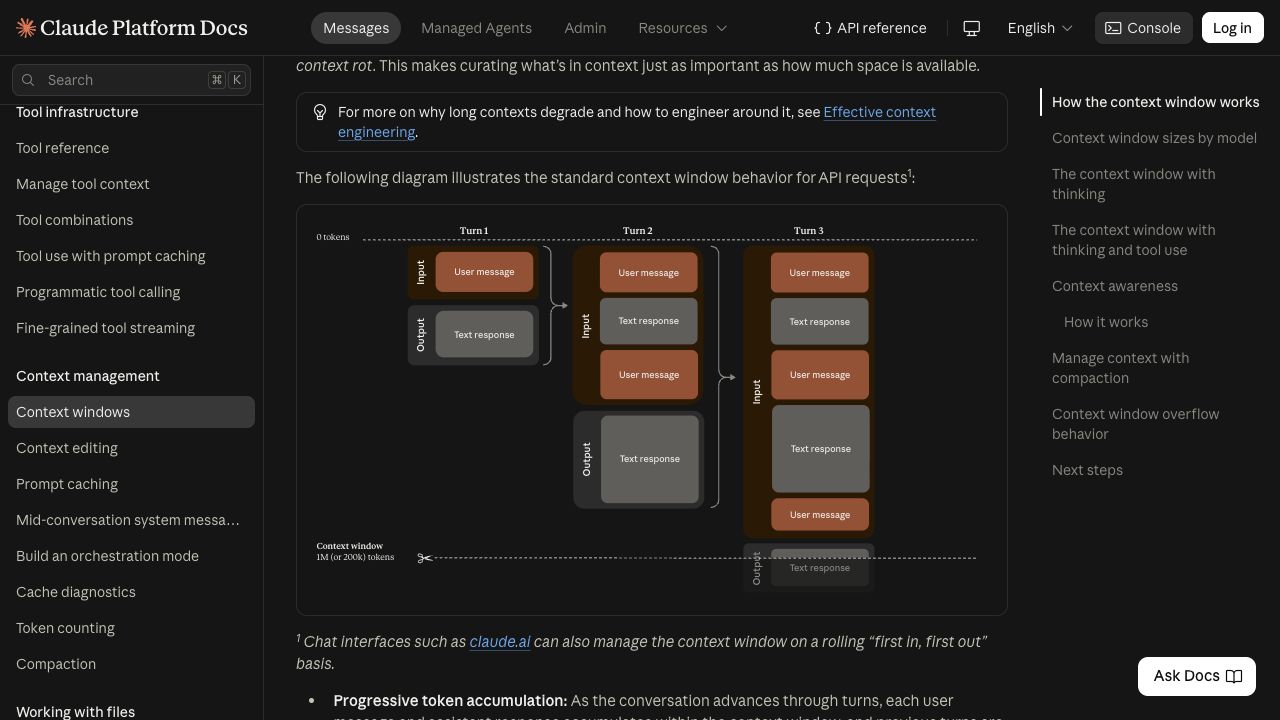
图:Anthropic 的上下文示意。每轮产生的回答,可能在下一轮成为输入;图中的容量标注是通用说明,具体以模型参数为准。
| 占用来源 | 常见内容 | 应该怎么处理 |
|---|---|---|
| 固定要求 | 系统提示、格式规则 | 保留必要内容,减少重复 |
| 当前问题 | 这次要做什么 | 明确范围和完成要求 |
| 历史消息 | 之前的问答、工具结果 | 清理已无关的内容 |
| 文件与图片 | 报告、代码、截图 | 先挑相关部分 |
| 新的生成内容 | 思考、工具调用、正文 | 提前预留空间 |
token 是模型处理内容时使用的单位。中文、英文、代码、数字和标点,拆分后的数量会不同。同样是一页 PDF,纯文字页面和复杂扫描页面的处理方式也可能不同。
所以,不能写成“100 万 token 必定等于多少万字”或“必定能读几千页”。这种说法看起来方便,却容易让人在在日常使用中算错。
假如你要处理的是 API 请求,更稳妥的做法是先计数。下面的示例用于估算当前文字输入;实际请求还要包含你准备发送的系统要求、工具和其他材料。
import anthropic

client = anthropic.Anthropic()
messages = [{"role": "user", "content": "这里换成准备提交的材料"}]
count = client.messages.count_tokens(
    model="claude-opus-5-5",
    messages=messages,
)
print(count.input_tokens)
计数结果是规划用的依据,不能代替实际响应中的用量记录。提交长材料时,也要检查文件大小、格式和平台上传规则。
这是常规调用允许的最大输出量,不是每次都会生成的长度。API 里的 max_tokens 还可以设置一个更小的上限。
例如设置 max_tokens=4096,就不能期待一次生成几万 token 的报告。而且,思考也会占用这个预算,最终可见正文可能少于你设定的数量。
另一个常见误会是:“既然能输出 12.8 万,那输入已经接近 100 万也能照样再写。”实际上,上下文总容量和输出上限需要同时满足。为了方便理解,不妨先用这个保守思路规划:
全部输入+准备留给本轮生成的空间,应处于上下文容量以内;本轮生成也不能超过单次输出上限。
真实计量还可能涉及思考保留和上下文管理方式,接近容量时应以平台反馈为准,不要仅凭文档字数判断。
第一步先先建立材料清单。给文件编号,标清日期、版本、用途和大致内容,避免把旧版本和新版本混在一起。
第二步再先定问题。比如“比较这三份方案的交付范围”,比“把所有内容都分析一下”更方便得到准确结果。
第三步要先让模型找出处,再做总结。要求列出相关章节、原句或表格位置,找不到就写明缺失,不让它靠猜补齐。
第四步是给输出分段。长报告不妨先做目录和证据表,再逐章展开;每章检查完后,再整理成完整版本。
第五步要检查容易错的细节。优先核对日期、单位、数字、例外条款和资料之间的冲突。
容量够用和信息使用得好,是两回事。材料太杂、重复内容太多、多个版本互相矛盾,都会增加查找难度。
遇到遗漏时,不妨先问:“回答这道问题需要哪些文件和章节?”把范围缩小后,再要求它重新找证据。如果只是反复说“认真一点”,往往不如把相关内容单独提供有效。
也要区分模型遗漏和应用处理。聊天软件可能自动压缩旧消息;文件工具可能只读了部分页面。先核实原文是否真的进入了这次请求,再判断是不是模型没记住。
如果提示上下文过长,先减少无关历史和工具输出,再把资料按主题拆开。对跨文件问题,保留一份文件索引,让模型需要时再读取原文。
如果回答被截断,检查 stop_reason。遇到 max_tokens,应确认是预算不足还是确实需要分段输出;不要把截断内容直接当作完整报告使用。
如果上传失败,则另外检查文件体积和格式。文件字节数超限与 token 超限是不同问题,单纯提高输出预算没有用。
100 万上下文的价值,是让更多相关材料能放在同一次工作里。在日常使用中,先确定问题、测量输入、留出输出空间,再通过原文核对结果,比一开始就把容量塞满更实用。
Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]