

Kimi K3 在真实 Astro 项目中的代码审查能力如何?
2026-10-27
2026-10-30 0
Opus 5.5 发布后,常见的两个数字是“输入输出单价下降 20%”和“典型任务成本约下降 40%”。它们并不矛盾:前者比较每个计量单位的价格,后者比较做完同一项工作一共花多少钱。
就像打印一页的价格降了,同时重复打印的废页也少了,最后做完一份材料的花费,可能比单页降价的比例更大。
Opus 5 的标准 API 输入、输出单价分别为每百万 token 5 美元和 25 美元。Opus 5.5 对应为 4 美元和 20 美元。
输入降幅为(5-4)÷5=20%;输出降幅为(25-20)÷25=20%。这个数字只需比较价目,不需要假设模型是否更聪明。
假设两个版本都使用 10 万输入 token 和 1 万计费输出 token:
| 项目 | Opus 5 | Opus 5.5 |
|---|---|---|
| 输入花费 | 0.50 美元 | 0.40 美元 |
| 输出花费 | 0.25 美元 | 0.20 美元 |
| 合计 | 0.75 美元 | 0.60 美元 |
相同用量下,费用下降 20%。注意这里说的是计费输出,包括需要计费的思考消耗,不能只数屏幕上的正文。
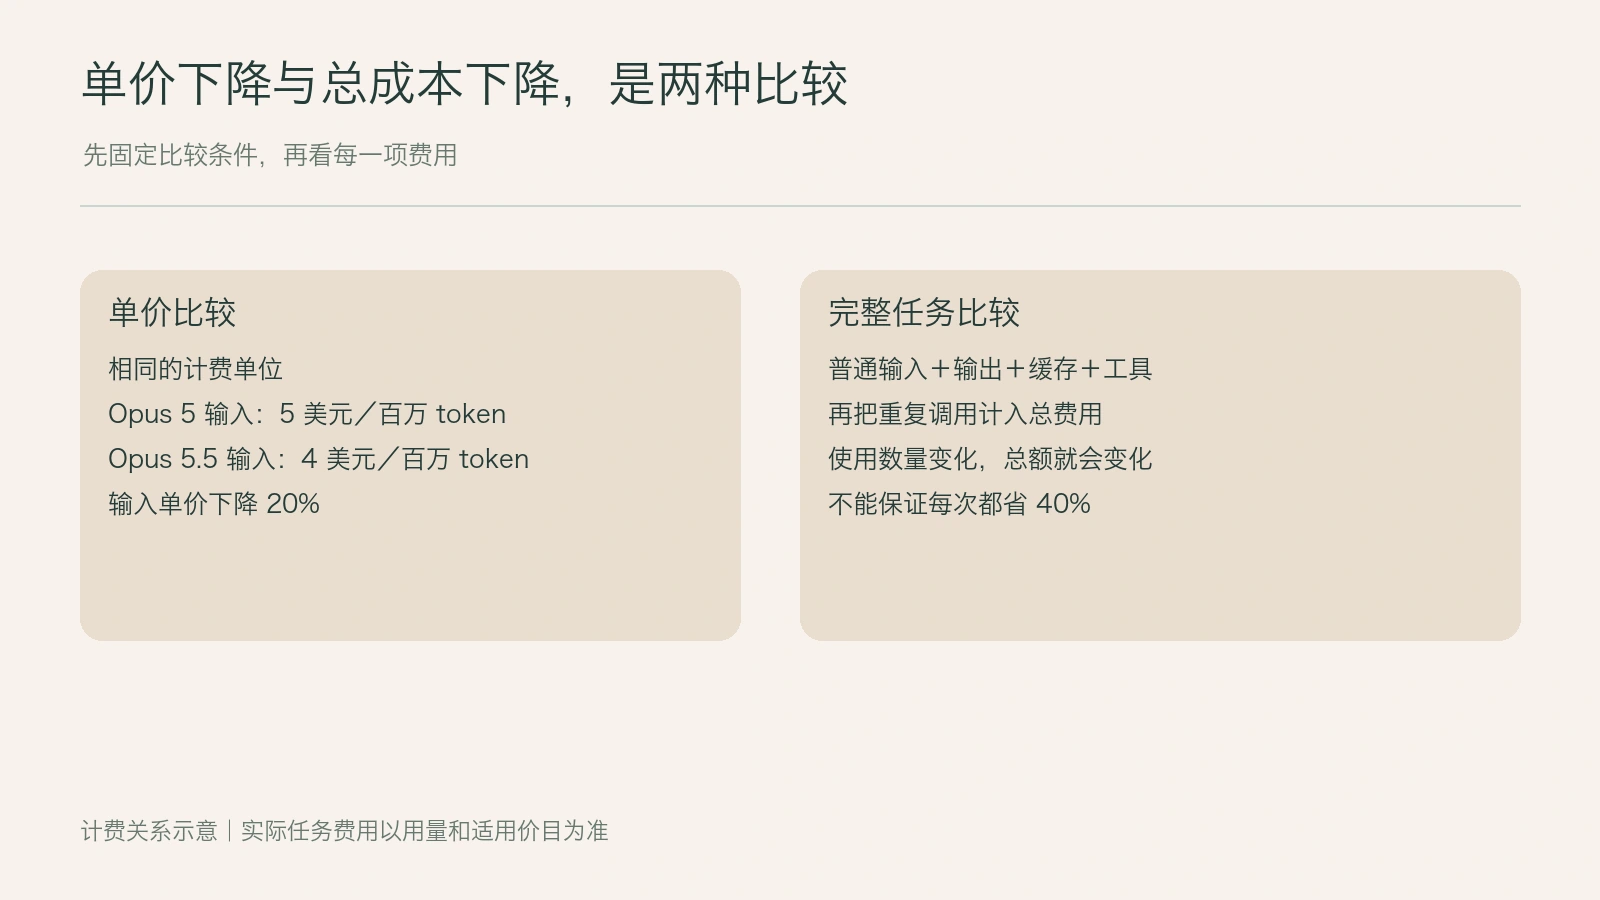
图:单价、使用数量和重复工作,共同影响最后的费用。
Anthropic 对典型工作负载给出的约 40% 成本下降,采用的是完成任务的角度。新版本价格更低,如果完成同样工作使用的 token 也更少,总花费就可能进一步下降。
为了说明算法,假设旧版本做完一项工作花 10 美元。在成本结构保持一致、只有输入输出两项的简化条件下:
这里的 25% 是计算示例,不是声称 Opus 5.5 每项工作都少用 25% token。实际任务的输入、输出、缓存和重试比例不同,结果也会不同。
Opus 5.5 的缓存读取价格,从每百万 token 0.50 美元变成 0.20 美元,单项降幅是 60%。这又是另一种计费项目。
如果一个工作流程经常反复读取相同的长材料,缓存读取占比可能比较高,实际降幅就不会只由普通输入、输出单价决定。
反过来,如果每次都是全新材料,没有有效缓存,不能把缓存读取的低价套在全部输入上。建立缓存还有写入费用,也要算进总账。
有几种很常见的情况。第一,任务量增加了。原来每天调用 20 次,现在每天 100 次,即使单次便宜,月也可能更高。
第二,思考程度不同。把新版本设成更高的 effort,可能增加思考和输出消耗。不能一边加大工作量,一边要求按固定比例下降。
第三,开启了 Fast Mode。它按更高单价收费,不能再按标准模式估算。
第四,程序重复提交了完整历史或大段日志。模型单价下降,也抵不过持续累积的无关输入。
第五,失败后整项任务从头重跑。特别是带有外部操作的流程,应先核实前面已经做了什么,再决定从哪里继续。
先选一组固定任务,保留相同输入和完成要求。至少覆盖短任务、常见任务和最复杂的一类,避免只挑新版本表现可以优先的一项。
对每项任务记录:调用次数、普通输入、缓存写入、缓存读取、计费输出、工具费用,以及最终是否通过检查。
然后比较“合格结果的平均花费”。例如旧版本 10 次尝试共花 12 美元,得到 8 个合格结果,平均每个合格结果 1.50 美元;新版本总花 10 美元,得到 10 个合格结果,平均为 1 美元。
这组假设数据的降幅约为 33.3%,不是 40%。即使没有达到宣传中的典型降幅,也可能值得使用,因为你自己的任务结构不同。
如果旧版本需要你修改半小时,新版本只需十分钟,节省下来的人工时间当然有价值。但这是另一项收益,不能据此把 API 也写成同样的降幅。
可以做两张表:一张只看服务,另一张记录检查和返工时间。需要评估总投入时,再用你自己的时间成本把两项合并。
| 你想比较什么 | 应该固定什么 | 应该记录什么 |
|---|---|---|
| 单价变化 | 相同计费单位 | 价目差额 |
| 单项工作费用 | 相同完成要求 | 所有调用与工具费用 |
| 整体工作投入 | 相同质量要求 | 服务费用和人工时间 |
比较的是普通输入、输出,还是缓存读取?比较的是相同 token 用量,还是做完同一任务?测试使用什么思考程度和速度模式?
把这三件事问清楚,再看结果有没有包含重试和失败任务,就不容易被数字带偏。20% 是标准输入输出单价变化,约 40% 是特定典型任务条件下的整体结果。自己的预算,仍然要用自己的工作记录来算。
Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]