

Kimi K3 在真实 Astro 项目中的代码审查能力如何?
2026-10-27
2026-10-30 0
本文以标准 API 用量比较为主。
Sonnet 5.5 的标准输入、输出单价,都是 Opus 5.5 的一半。但选模型不能只看单价:如果便宜的版本需要更多轮修改、更多工具调用或更多人工返工,做完同一项工作未必更省。反过来,简单任务一次就能做好,也没必要默认选择更贵的版本。
| 项目 | Opus 5.5 | Sonnet 5.5 |
|---|---|---|
| 标准输入/百万 token | 4 美元 | 2 美元 |
| 标准输出/百万 token | 20 美元 | 10 美元 |
| 常规上下文 | 100 万 token | 100 万 token |
| 常规最大输出 | 12.8 万 token | 12.8 万 token |
| 默认 effort | medium | high |
| 基本方向 | 长任务编程、复杂知识工作 | 速度和能力之间取平衡 |
上下文相同并不表示效果完全相同;默认 effort 不同,也提醒我们不能只看参数名字就认为处理消耗一致。
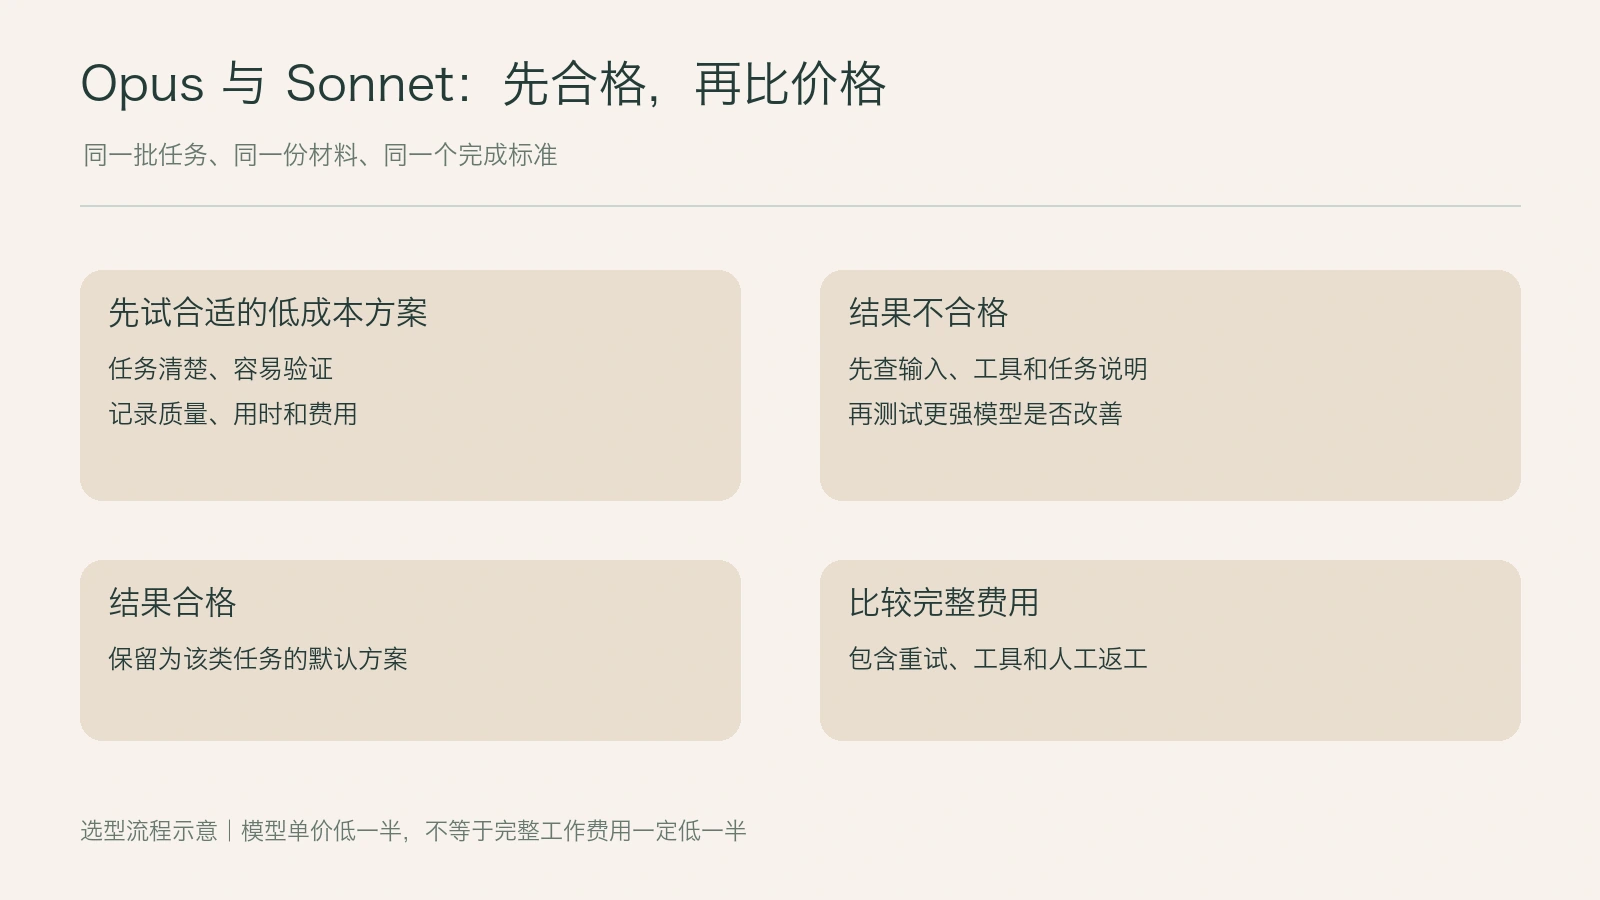
图:先比较能否合格完成,再比较费用和时间;图中并不表示固定胜负。
要求比较明确、验证方法直接的工作,不妨先试 Sonnet。例如短资料整理、常见文案改写、字段提取,或范围清楚的小代码修改。
“先试”不等于一定够用。你还要检查它是否遵守格式、有没有漏条件,以及是否需要多次补充说明。
如果 20 个同类任务都能一次合格,Sonnet 的低单价更方便转化为真实节省。用更贵模型得到差不多的结果,通常没有额外收益。
涉及多个文件、条件互相影响、需要连续排查和核对的任务,可以把 Opus 加入比较。例如复杂故障定位、多份长资料中的冲突分析,或需要保持前后约束的大规模修改。
但不要把任务名当成保证。某次“复杂分析”如果材料本身不完整,换更贵模型也可能答错。先把输入和检查方法准备好,再比较两个模型。
假设一项任务中,Opus 使用 10 万输入 token 和 1 万计费输出 token,总费用为 0.60 美元。相同用量下,Sonnet 为 0.30 美元。
如果 Sonnet 一次做完,确实便宜一半。但假设它需要三轮同等成本的尝试才得到合格结果,总计就是 0.90 美元,高于 Opus 的 0.60 美元。
这只是说明计算方式,并不表示 Sonnet 实际一定要重做三次。现实中,每轮输入、历史和输出都不同,必须按真实相加。
此外,如果 Opus 也需要反复重做,那它同样可能更贵。比较应该使用两边的实际结果,而不是替某个模型假定完美表现。
先把 API 和人工时间分别记录。比如模型 A 花 0.30 美元但需要检查 20 分钟,模型 B 花 0.60 美元但只需检查 5 分钟,后者是否划算,取决于这 15 分钟对你有什么价值。
不要把人工节省混进“API 便宜多少”的数字里。可以同时展示服务费用、完整耗时和人工修改量,再做决定。
第一步先从自己的工作里选 10 到 20 项任务,包含常见、简单和最容易失败的几类。
第二步再给相同材料和完成要求。代码任务明确通过哪些测试,资料任务明确哪些字段必须有原文依据。
第三步要先测试各自合理的默认设置。然后对比思考程度时,单独改变设置,记录原因,不要同时更换一整套工具。
第四步是给每项任务打合格或不合格,再记录总费用、总时间和人工修改量。只看回答长短无法判断质量。
第五步要按任务类型决定默认模型。必要时保留升级路线,而不是全公司的所有任务都只用一个版本。
一个可行思路是:Sonnet 先处理明确的小任务;验证失败、条件复杂或风险较高的部分,再交给 Opus 复查。这里的风险指工作出错后影响较大的情况,应根据业务自己定义。
升级前先保存当前材料和失败点,让 Opus 知道哪里没通过,而不是整项工作毫无说明地重跑。
混合流程也有成本:模型切换、重复输入和上下文处理需要额外费用。只有实测证明总体更好,才值得加入自动分流。
聊天套餐不等同于标准 API 价目;不同入口有各自的额度和模型访问条件。API 版本之间的思考和工具规则,也应分别检查。
尤其不要把 Sonnet 的思考配置直接复制给 Opus。Opus 5.5 始终开启自适应思考,模型规则不同,程序可能返回参数错误。
最终选择可以很简单:能够稳定合格完成的小任务,优先比较更低成本方案;难题和返工较多的任务,再衡量 Opus 是否能用更少总投入做完。
Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]