


GPT-6 Astra 是怎么找到问题所在的?结构分析与反馈定位过程
2026-11-06
2026-11-06 0
六成以上不能直接解释为六成企业已把开放模型用于核心业务。若没有目标时间、调查对象和采用标准,这一比例不能作为采购依据。企业数量、工作负载与平台 token 的分母不同,判断之前要先分清统计对象。
企业采用率,通常问一家企业是否在至少某个场景使用;工作负载比例,问多少任务交给这类模型;token 份额,问模型处理了多少文本单元。一家公司只在内部工具使用一次,与大部分业务依赖开放模型,都可能被宽泛的“采用”统计计入。
| 数字的类型 | 能说明什么 | 不能直接说明什么 |
|---|---|---|
| 企业采用比例 | 有多少受访企业接触或部署 | 核心业务规模、实际使用深度 |
| 工作负载占比 | 任务分配方向 | 多少家企业已经完成迁移 |
| 平台 token 份额 | 该平台的处理量结构 | 全球企业市场份额或收入份额 |
IDC 对 2028 年的预测讨论的是企业将 60% 的 AI 工作负载从专有大模型转向开放模型,以路由方式控制成本和依赖。这个比例数的是工作负载,不是企业采用率,也不是 Gartner 的同一项预测。把机构、年份和分母一起省略,意思就变了。
即便预测方向成立,也不意味着所有任务都迁移。企业可能把批量分类交给开放模型,复杂推理继续使用闭源服务。这样既能增加开放模型的处理量,也可能让闭源模型的绝对使用量继续增长。
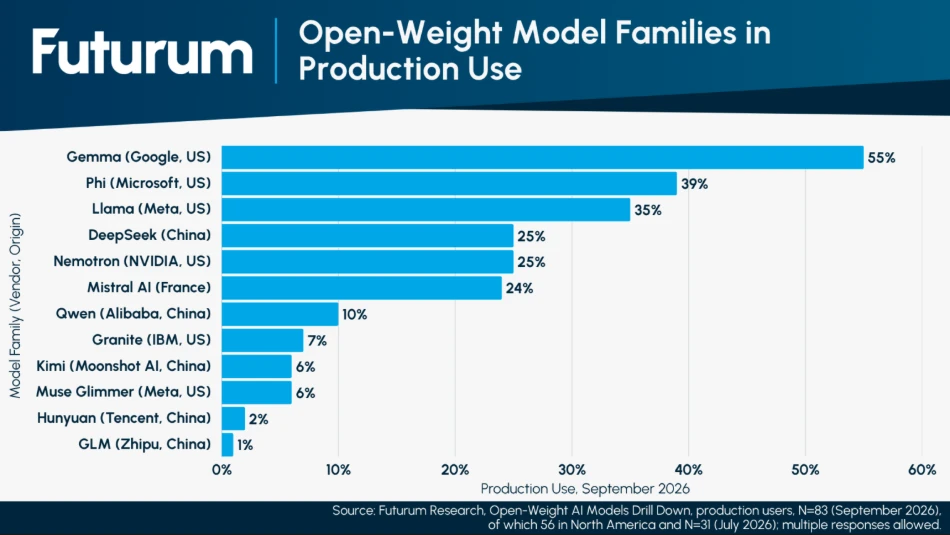
Futurum 的 2026 年 9 月调查,在 200 家受访企业中观察到 42% 已将开放权重模型用于生产。样本偏向北美,不能直接推广为全球企业比例。它与十月另一项调查中的“某种形式使用”又不是相同标准,因此不能拼成一条没有断点的增长曲线。
这类结果可说明开放模型已经进入生产,但不足以证明某个笼统的“六成以上”数字适用于所有地区与行业。试验、生产、跨部门规模化,最好分别列出,而不是归为一个采用状态。
任务能力提升、部署选择增多、重复调用成本和数据边界要求,都会推动企业尝试开放模型。推理框架、量化工具和托管服务降低了接入难度。但人才、运维、许可审核和系统整合仍会拖慢从试用到生产的速度。
因此,增长趋势可有合理解释,某个精确百分比却仍需对应的统计定义。预测是对未来的判断,调查是对样本的观察,两者都不等于已完成的全市场普查。
与其用“别人都在上”立项,不如选一个有明确业务量和验收标准的场景,记录合格率、处理成本与人工接手比例。若开放模型达标,再扩大范围;若仍需大量返工,就保留原方案。采用率可帮助观察行业,不能代替本企业的可行性验证。

Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]