


GPT-6 Astra 是怎么找到问题所在的?结构分析与反馈定位过程
2026-11-06
2026-11-06 0
Astra 的定位依赖结构分析、Python 权重工具、练习输入与受限前向反馈,并非一次读完所有参数后凭直觉作答。具体工具和预算决定了它可以观察什么、怎样验证修改。
模型表现差可能有很多原因:推导错误、知识不足、输出格式不对,或反复重复直到耗尽长度。这个实验中,大量练习回答无法正常结束,因而循环是优先要解释的现象,而不是先假设数学知识缺失。
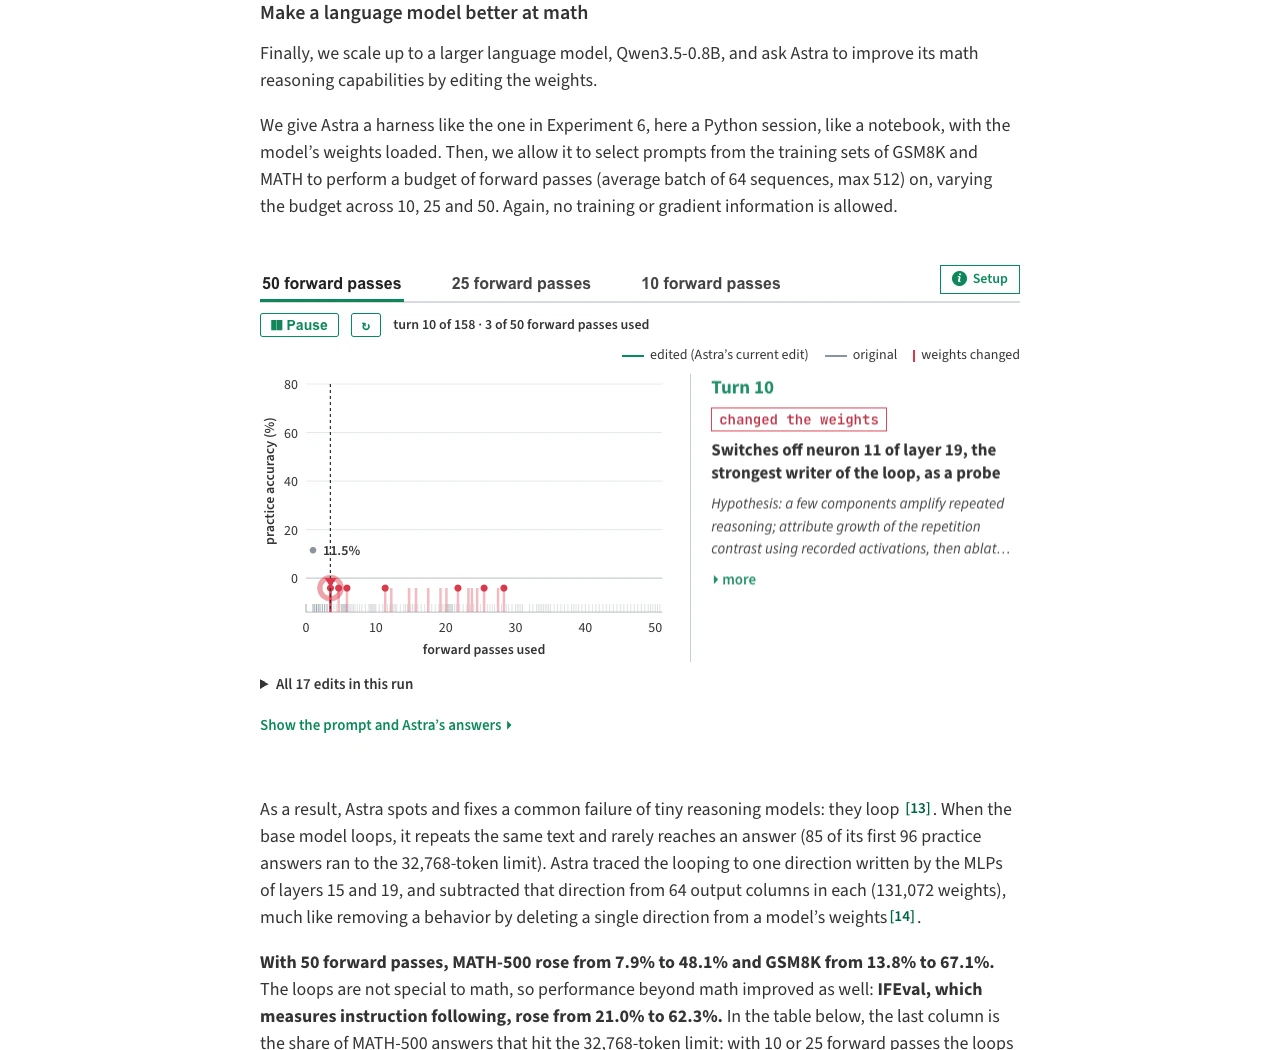
Astra 可通过 Python 分析张量,在允许的预算内观察前向反馈。这里的“直接编辑”不意味着没有工具或没有试验。操作不经过梯度优化,但仍需数据读取、计算和结果判断。
大的参数文件不适合完整塞入上下文,选择看什么、怎样汇总和比较,都会影响定位效率。工具程序与任务限制不能在传播时省略。
研究将循环与部分 MLP 层写入的方向联系起来,再减少选定输出列中的相关成分。它不是看到某层参数大就随意清零,也不是保证任意架构中的相同层号承担同一职责。
神经网络中的结构关联需通过干预验证。仅观察到相关性,还不足以说明已找到唯一原因;真正有价值的是修改后目标行为变化,和其他行为是否保持。
前向调用可包含批量序列,有限次数不等于有限几道题。不同预算下的收益也不相同,不能把最终较好结果解释为第一次随手修改就得到。
实践中应保留每次候选编辑、反馈和选择依据,否则难以区分方法本身的效果与试验选择带来的偏差。
定位阶段可参考练习集合,最终质量应由未用于选择修改的评测任务检验。除了目标数学分数,还要核查循环、指令遵循和其他能力,防止以牺牲通用表现换取单项数字。
精确权重版本、架构、张量布局、采样和长度上限都可能不同。相同品牌下另一个模型不一定存在相同障碍,层号也不具备普遍意义。迁移时应重新诊断,而不是按数字位置机械修改。
这个过程展示的是受控的模型诊断与干预,并没有让内部机制变成完全透明的源码。定位记录、验证和回滚仍然不可省略。

Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]