


前端弹性布局神器display:flex完整指南
2026-11-17
2026-11-17 0
同一模型逐篇接收相同的原文和提示词时,排队批量跑与手动逐篇提交的差别主要在操作量。把几篇稿子塞进同一次模型请求,则会改变输入长度和任务边界,需要额外检查漏稿、截断和串稿。稿件差异越大,越有必要按篇补充改写要求。
可以从日常稿件里取 12 篇,长短和体裁都留几篇。让相同的稿件分别接受批量调度和手动提交,尽量统一模型版本、提示和输出限制。若还想了解多稿同请求的表现,可把这种用法另做一轮。
将结果按稿号配对,把两种来源的标签隐藏后再核对。每篇先对照原文的数字、时间、产品名称和限定条件,再检查是否丢段、重复或混入别篇内容。事先定好通过标准,例如关键事实完整、结构符合要求、无需编辑返工。分别记录两组数据。
| 指标 | 怎么记 | 用于判断什么 |
|---|---|---|
| 首轮通过率 | 无需返工的稿件数 ÷ 提交总数,失败和漏稿也计入总数 | 是否交出了更多可用初稿 |
| 人工用时 | 累计提交、检查和返工的实际操作时间 | 编辑是否省下时间 |
| 交付耗时 | 从提交首篇到全部稿件通过检查的时间 | 整批稿件何时可用 |
按算例看,12 篇稿里批量通过 9 篇,逐篇通过 10 篇,首轮通过率相差约 8.3 个百分点。假设批量少花 10 分钟提交,多花 4 分钟返工,其余人工操作用时相同,则人工共省 6 分钟。交付还要记录排队和生成时间,才能看出稿件是否更早可用。
需要把固定规则反复用在一批稿件上,可以用 n8n 编排流程。n8n 2.48.4 中,双击 Loop Over Items 节点,在 Parameters 的 Batch Size 填每轮取出的稿件数。图中填 3 时每轮最多交给下游 3 条,填 1 时每轮取 1 条。改写节点要接在 loop 出口,并把处理完的数据接回循环节点,最后由 done 出口汇总。
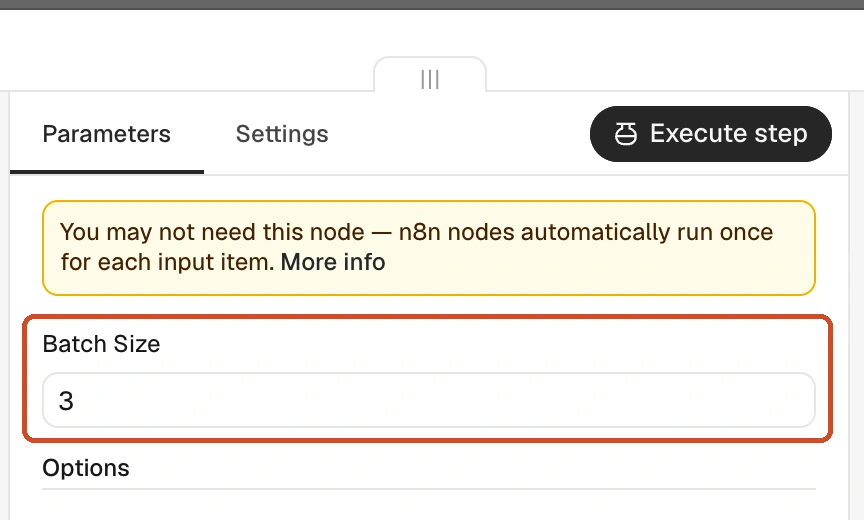
每批取几条只控制流程何时把数据交给下游。模型调用次数、并行度和是否合并正文由下游节点及所用模型服务决定。要只比较调度方式,就给每篇保留稿号和独立请求,结果按稿号回写。遇到输出长度限制或接口限流,可单独记下失败稿号,避免把它们漏出统计。
如果返工主要来自统一的标题或段落规则,可先修订通用提示,再用几篇样稿复核后扩大批次。如果返工集中在专有名称、关键数值和长文结构,把这类稿件分到逐篇处理队列。同一批里也可保留每篇的专属要求,让规则统一的正文继续走批处理。

Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]