

平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“VibeCoding中的OpenSpec与Spec-Kit采用”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
实际处理时,OpenSpec 和 Spec-Kit 都是“先写规范、再写代码”的规范驱动开发(SDD)工具,但两者思路完全不同: OpenSpec 管“变更”,Spec-Kit 管“契约”理解这一步时,。轻松说,OpenSpec 像给 AI 派发“任务书”,每次改动都走提案、执行、归档的闭环;Spec-Kit 像给 AI 发“员工手册”,先立一套长期有效的项目规矩,AI 每次干活都先读它。
一、为什么需规范驱动开发
实际处理时,最近市场也是越来越卷了,在项目里,也是要求用AI开发,我相信用过AI开发的小伙伴,都遇到了,AI越写越乱,越写越成屎山。用 AI 写代码最让人头疼的,不是工具不好用,而是你想要的和 AI 做出来的根本不是一回事。你让它加个登录功能,它给你整了一套 OAuth2 + JWT + 微服务架构;你让它改个按钮颜色,它把整个样式系统重构了。
实际处理时,其根源在于需求没说清楚,AI 就开始自由发挥。规范驱动开发的核心思路很轻松:先说清楚要做什么,再让 AI 动手。 官方说法叫 “Agree before you build”,但我觉得更叫:提示词优化/提示词工程
最近也一直有一个名词叫; SDD 驱动开发,那么什么是SDD?
SDD 全称: Spec-Driven Development (规范驱动开发)
它指的是一种开发方法:先把“要做什么、为什么做、做到什么程度算完成”写成结构化、可审查、可验证的规范,再让 AI 或人按规范去实现和验收。
这里通常都是围绕着一个Spec。那Spec 是什么?
Spec是:“需求文档”,“目标与背景”,“验收标准”,“接口契约”,“边界条件”,“技术方案”,“任务清单”,“验证方式” 等等,能够理解为一个目录下包含上述的文档。
理解这一步时,而目前开源的SDD开发框架,最火热的就是OpenSpec 和 Spec-kit
两大AI驱动框架.
理解这一步时,在 OpenSpec 里则落在了:proposal.md,design.md,tasks.md
结合项目来看,在 Spec-Kit 里则落在了:constitution.md,spec.md,plan.md,tasks.md
二、OpenSpec:轻量级规范驱动开发
2.1 核心结构
openspec/
├── specs/          # 已实现的功能(真相之源)
└── changes/        # 待实现的提案
    └── [变更名]/
        ├── proposal.md   # 为什么要做、做什么
        ├── design.md     # 技术方案
        ├── tasks.md      # 实施清单
        └── specs/        # 规范增量(补丁)
两个文件夹的分离是关键设计:在这个场景下,specs/ 存放当前系统的真实状态,changes/ 存放提议的更新。这种设计让状态和变更分开管理,在修改现有功能或跨多个规范时尤其有效。
其次就是config.yml 的作用:实际处理时,一次性告诉 AI 这些项目级上下文,之后每次生成规范、设计或任务时,AI 都会自动带上这些信息,不需你反复在对话中强调
OpenSpec 的设置文件位于 openspec/config.yaml从实现思路看,。它扮演着整个项目的“世界观”和“全局标准层”角色,AI 编码助手在执行任何具体任务前,都会先读取这个文件,以确保编写的代码符合团队规范。
如何采用: 理解这一步时,你能够告诉AI,让它编写config.yaml,加入你项目的架构,编码风格,规范等。
config.yaml 中核心字段解析:
| 字段 | 作用 |
|---|---|
| schema | 实际处理时,设置默认工作流 schema,免去每次命令都输入 --schema spec-driven |
| context | 注入项目上下文,AI 在所有制品生成时都会看到你的技术栈和约定 |
| rules | 理解这一步时,按制品类型添加规则,比如 proposal 必须包含回滚方案,specs 必须用 Given/When/Then 格式 |
| operations | 理解这一步时,为 apply 和 archive 操作提供建议性指引,不约束制品内容,只影响 AI 执行这些操作时的行为 |
| githubCopilot | 控制是否生成 GitHub Copilot 云端 Agent 相关文件 |
2.2 安装
前置要求: Node.js ≥ 20.19.0
# 全局安装
npm install -g @fission-ai/openspec@latest
#AI安装-前提是手动安装好Node.js ≥ 20.19.0
请你帮我安装好OpenSpec,以下是OpenSpec的项目连接地址:https://github.com/Fission-AI/OpenSpec
# 验证安装
openspec --version
2.3 项目初始化
# 切换到你的项目下
cd your-project
#执行,就会生成(2.1 核心结构)文件
openspec init
理解这一步时,初始化是交互式的,会询问你要设置哪些 AI 工具(Claude Code、Cursor、GitHub Copilot 等)。也能够用 --tools 参数跳过交互:
# 指定配置 Claude Code 和 Cursor
openspec init --tools claude,cursor
# 配置所有支持的工具
openspec init --tools all
# 跳过工具配置
openspec init --tools none
# 执行
openspec init
OpenSpec 会自动检测项目中已有的工具目录(如 .claude/、.cursor/)同时预选
2.4 核心工作流
OpenSpec 的核心工作流很简洁,三阶段即可跑通
| 阶段 | 命令 | 功能 |
|---|---|---|
| 规划 | /opsx:propose | 新建变更提案,一次性生成全部规划文档 |
| 实施 | /opsx:apply | 按任务清单实现代码 |
| 归档 | /opsx:archive | 归档已完成变更,更新主规范 |
除了核心三命令,还有几个实用命令
| 命令 | 用途 |
|---|---|
| /opsx:explore | 探索想法、调研问题(只读),你能够和AI讨论你的需求,看下AI的想法 |
| /opsx:new | 实际处理时,新建新变更(逐个生成工件),只是一个空的changs,一般搭配/opsx:continue 命令一起采用,能够让你逐步审核每个文件 |
| /opsx:ff | 一次性生成所有规划文档 |
| /opsx:verify | 验证实现与规范的一致性(只读) |
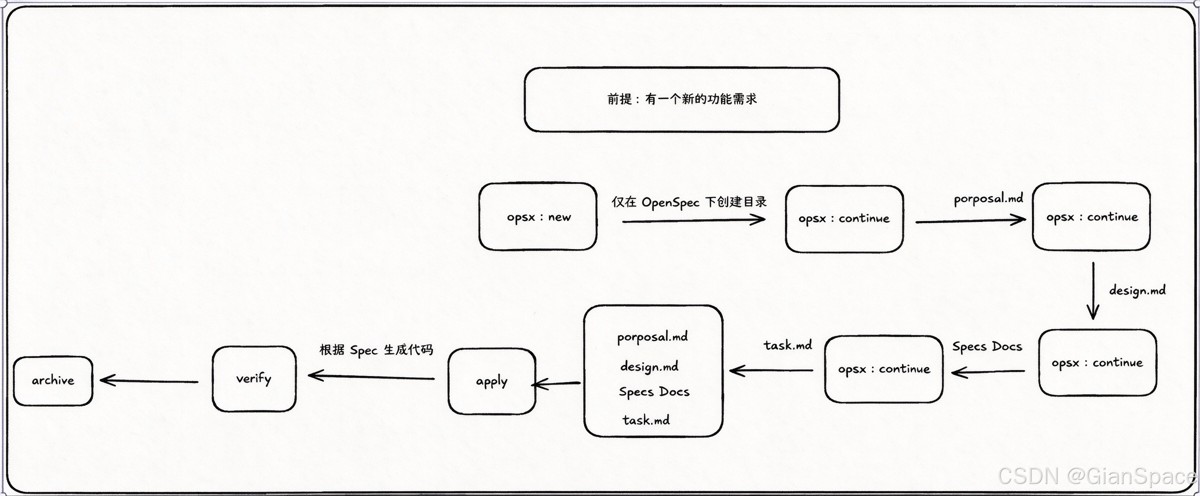
加上以上命令就能够完成:Expanded模式的流程开发
new -> continue ->apply ->verify->archive
五步实现更精准的控制
结合项目来看,CLI 终端命令方面,openspec list 列出进行中的变更,openspec show [item] 查看详情,openspec validate [item] 验证格式,openspec archive --yes 非交互式归档
2.5 在项目里的实际采用命令流程
以下是我正常开发迭代写需求的流程
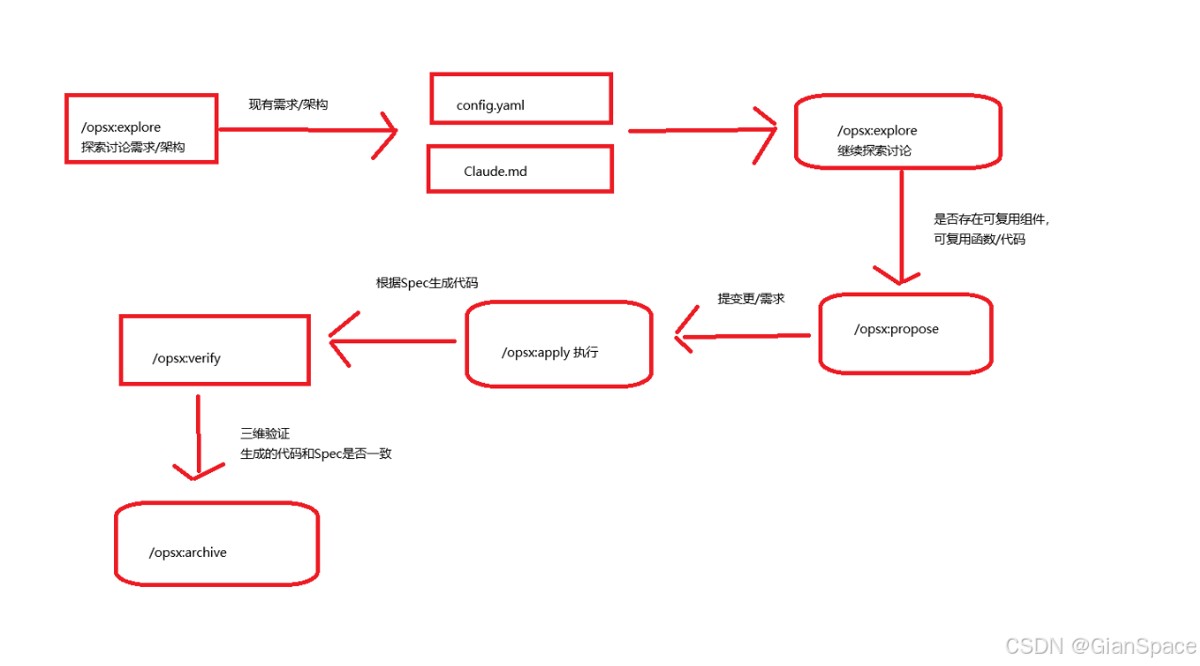
- 采用/opsx:explore 探索想法跟需求
- 采用/opsx:propose 新建变更提案,一次性生成全部规划文档
- 在这个场景下,轻松查看以下提按的内容(proposal.md,design.md task.md)
- 采用/opsx:apply 按任务清单实现代码
- 采用/opsx:verify 验证实现与规范的一致性
- 最后/opsx:archive 归档已完成变更,更新主规范
理解这一步时,当然,如果不放心,怕AI编写代码有偏差,想多看几眼,把控细节。能够采用/opsx:new 跟 /opsx:continue 一起采用,具体流程如下所示:
2.6 在项目里的实际采用场景
场景一: 在这个场景下,存量项目添加新功能。 这是 OpenSpec 最擅长的场景。在现有代码库中执行 openspec init,OpenSpec 会扫描现有代码和规范,理解当前系统能力,随后生成增量变更提案。不需重构现有代码,能够逐步引入。
场景二: 结合项目来看,修复 Bug。 先用 /opsx:propose 描述 Bug 现象和预期行为,AI 会读取现有 specs 理解系统,随后生成修复方案和任务清单,再用 /opsx:apply 实施。
场景三: 理解这一步时,新项目从零开始。 虽然 OpenSpec 更擅长存量项目,但也兼容全新项目。从第一个功能开始就用 /opsx:propose 建立规范体系以及config.yml 文件后,后续所有开发都基于不断更新的 specs/ 展开。
落到代码里,OpenSpec 兼顾存量项目(Brownfield)和新建项目(Greenfield),但它的设计哲学更偏向“流动而非僵化、迭代而非瀑布
三、Spec-Kit:团队级规范驱动开发
3.1 Spec-Kit的核心
Spec-Kit 的核心工作流是:实际处理时,Specify → Plan → Tasks → Implement → Converge。每个阶段生成一个 Markdown 工件文件,作为下一个阶段的输入,给 AI 提供结构化的上下文,而不是零散的 prompt
Spec-Kit 的实现包含三个核心组件:
specify CLI:初始化和管理以规范驱动的项目
Markdown 工件文件:constitution.md、spec.md、plan.md、tasks.md
斜杠命令:
/speckit.specify、/speckit.plan、/speckit.tasks、/speckit.implement
3.2 Spec-Kit的安装
Spec-Kit 的安装依赖 uv(Python 包管理器)
# 先安装 uv(如果还没有)
curl -LsSf https://astral.sh/uv/install.sh | sh
# 安装 Specify CLI(替换 vX.Y.Z 为最新版本号)
uv tool install specify-cli --from git+https://github.com/github/[email protected]
# 也可以从 PyPI 安装
uv tool install specify-cli
# AI安装:请帮我群居安装spec-kit,github地址为:https://github.com/github/spec-kit
验证安装:
specify check
在这个场景下,specify check 会检查系统中已安装的工具,包括 git、claude、cursor-agent 等
3.3 项目初始化
# 创建新项目并指定 AI 集成
specify init my-project --integration copilot
# 在当前目录初始化
specify init . --integration claude
# 非交互模式(适合 CI 环境)
specify init my-project --non-interactive --integration claude
3.4 AI工作流程的采用
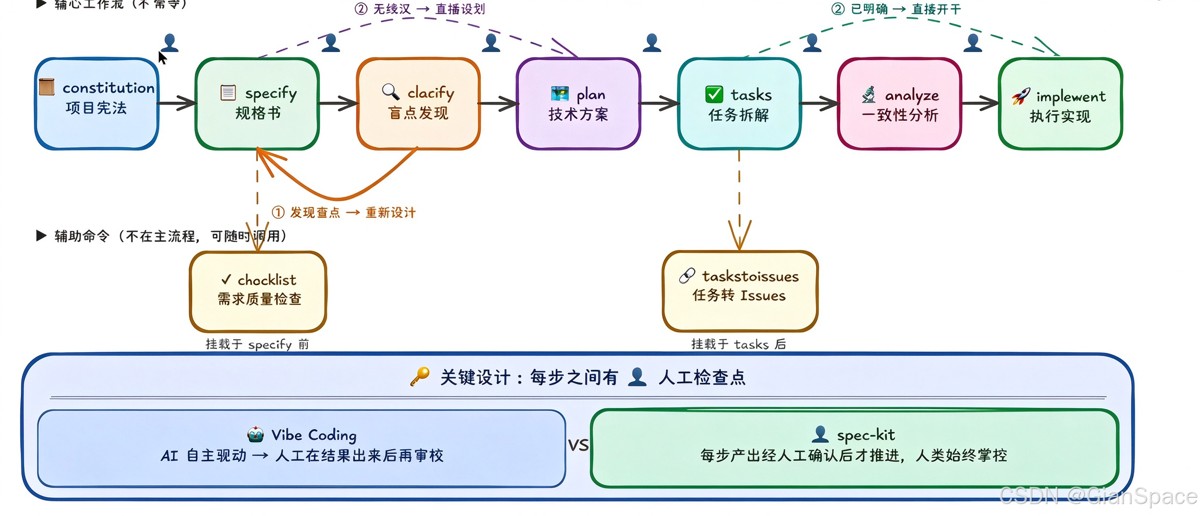
结合项目来看,Spec-Kit 采用严格的七步工作流,每一步生成一个文件,共同构成功能的“完整规范体系”。
| 阶段 | 命令 | 用途 |
|---|---|---|
| 项目原则 | /speckit:constitution | 新建项目治理原则(每个项目一次) |
| 规范 | /speckit:specify | 描述要构建什么(关注 what 和 why) |
| 盲点 | /speckit:clarcify | 需求有疑问时澄清 |
| 规划 | /speckit:plan | 制定技术实现方案(提供技术栈和架构选择) |
| 任务分解 | /speckit:tasks | 将技术方案分解为可执行任务清单 |
| 实施 | /speckit:implement | 按任务清单逐步实现代码 |
| 收敛 | /speckit:converge | 对照规范验证实现是否一致 |
此外还有辅助命令: /speckit:analyze(检查遗漏)、/speckit:checklist(生成质量检查清单)
3.5 扩展
能够借助CMD或者PowerShell 输入
列出可安装的扩展命令:specify extension search “”
安装扩展: specify extension add
卸载扩展: specify extension remove
列出已安装的扩展:specify extension list
查看扩展详情: specify extension info
更新扩展: specify extension update []
启用扩展的 hooks: specify extension enable
禁用扩展的 hooks: specify extension disable
主题皮肤等
列出可安装的Presets / 主题命令:specify preset search “”
安装预设:specify preset add []
列出已安装的预设:specify preset list
移除预设:specify preset remove
查看预设详情: specify preset info
对此:我们能够借助:specify preset add Lean
来安装精简版的五命令模式。 Spec-Kit 其实默认是Full的九命令模式,如下所示图:
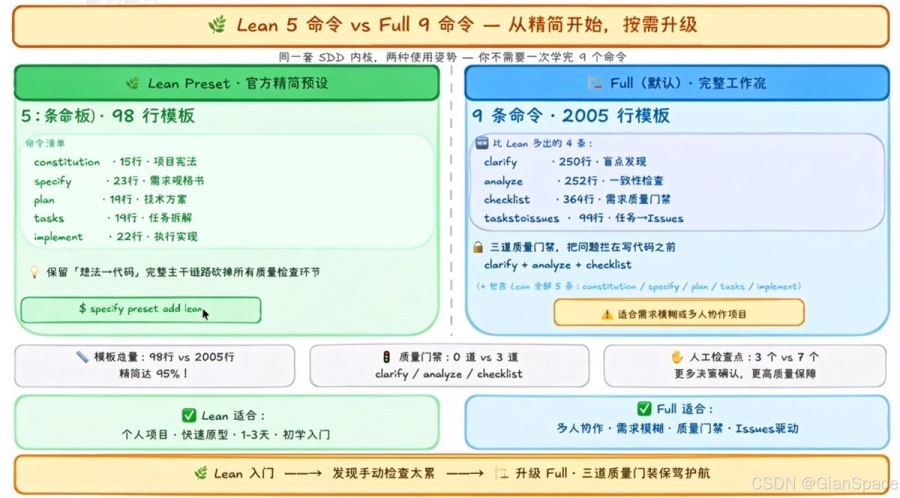
五命令模式流程为: /speckit:constitution -> /speckit:specify -> /speckit:plan -> /speckit:tasks -> /speckit:implement
九命令模式流程为:/speckit:constitution -> /speckit:specify -> /speckit:clarcify -> /speckit:plan -> /speckit:tasks
->/speckit:taskstoissues -> /speckit:analyze -> /speckit:implement -> /speckit:checklist
3.6 constitution
实际处理时,其实在采用 Spec-Kit 采用得好不好,好不好用,其关键在于constitution(宪法/规约)写得好不好,OpenSpec 其实也是一样的道理 config.yml 写得好,那么返工就少,问题也就少。
那么如何写好constitution(宪法/规约)呢? 我总结提出了几个点:
- 标明: 行为边界/职责领域等,不让AI越界操作
- 禁止项写死:每次执行都参考宪法约束
- 每步可纠错可控:误差不累计,不雪崩
- 代码复用强制:写明必须要复用的情况,避免给重复造轮子
好的 constitution(宪法/规约)或者 OpenSpec的 config.yml 应该遵循六大写作原则
- 禁止项 > 允许项:限制比授权更有约束力
- 具体 > 抽象:函数(Function)< 60 而非一直写下去,同时需要复用
- 开篇定义范围,禁止AI擅自扩展
- 落到代码里,每条附加根本原因,让AI知道为什么这样,才会真正遵守,比如:示例代码/逻辑依据
- 有版本才能有迭代,有需求才会有验收
- 规则限制等,最好控制在2000字以下,避免上下文过长,导致AI遗忘。
四类核心规则
- 代码复用策略:AI天生喜欢写,而不是度: 写>读
- 项目实际架构:不明确的禁止,防止AI擅自引入,特别是Router-Service模式
- 禁止的代码模式/规则:不让AI怎么写,方法函数必须控制在多少。
- 术语精确性:确保AI理解词汇,不产生歧义误解
3.7 项目中的实际采用场景
场景一:大型新项目从零开始
在这个场景下,Spec-Kit 的完整工作流保证了从项目原则到最后实现的完整覆盖。每一步的产出都是持久化的 Markdown 文件,存储在 Git 仓库中,能够像代码一样进行版本管理和代码审查。
场景二:团队协作与代码审查
理解这一步时,规范文件(spec.md、plan.md、tasks.md)能够随代码一起提交到功能分支。审查者能够同时看到“你要构建什么”和“你是怎么构建的”。Spec-Kit 还兼容借助环境变量 SPECIFY_FEATURE 跟踪当前开发的功能,在 Git 工作流中会根据分支名自动推断。
场景三:多 Agent 自由切换
落到代码里,Spec-Kit 兼容 38 种 AI 编码代理集成(Copilot、Claude、Cursor、Gemini、Windsurf 等),同一个项目能够在不同 Agent 之间自由切换,底层的工件文件是共享的
场景四:存量项目逐步引入
在这个场景下,对于已有代码库,采用 specify init . --here 就地初始化,随后从下一个新功能开始采用 SDD 流程。不需重构现有代码,能够逐步引入。
四、Spec-Kit 与 OpenSpec 的选型对比
4.1 全方位对比
| 维度 | Spec-Kit | OpenSpec |
|---|---|---|
| 定位 | 重型、流程严谨、GitHub 官方 | 轻量、灵活、社区驱动 |
| 安装 | uv tool install 需python环境 | npm install -g |
| 前置依赖 | Python 3.11+ / uv | Node.js ≥ 20.19.0 |
| 核心工作流 | 6-7 步完整流水线 | 3 步(propose → apply → archive) |
| 适用场景 | 新项目、大型团队、强规范需求 | 存量项目迭代、小团队、敏捷开发 |
| 规范增量 | 以完整规范为主 | Delta Spec 增量变更 |
| 学习成本 | 中高 | 低 |
4.2 工作流程对比如下所示图:
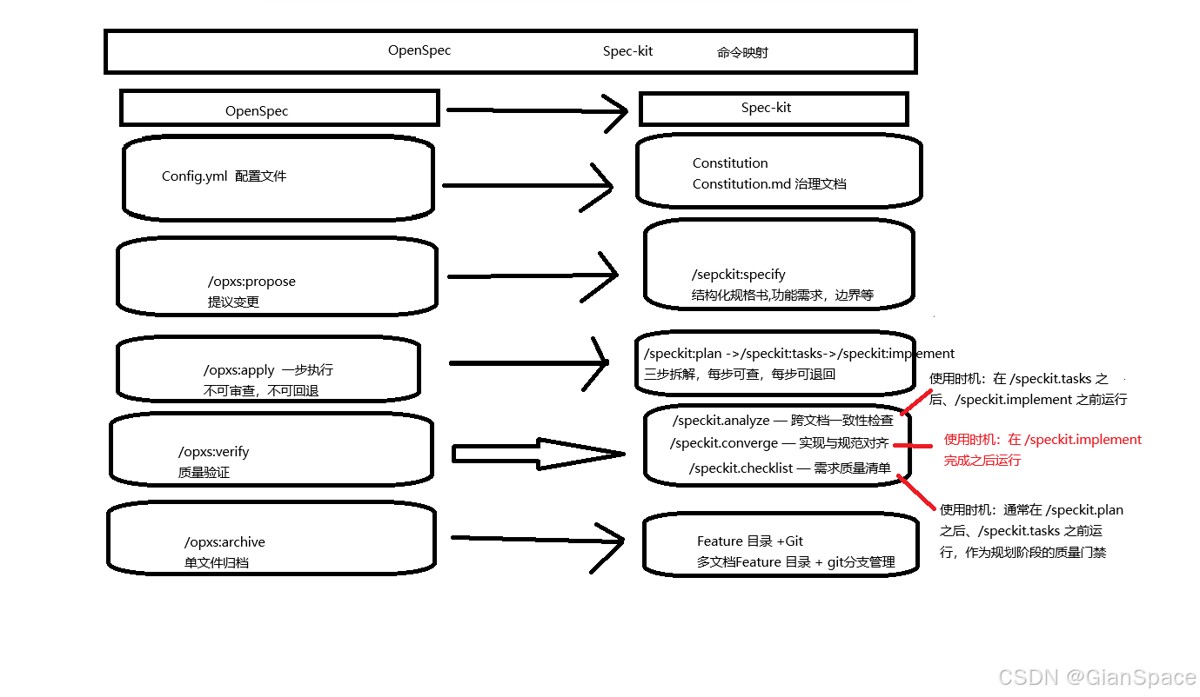
总结:选型建议:新项目、大型项目、需完整开发流程 → Spec-Kit;小项目、存量项目迭代 → OpenSpec
落到代码里,总的来说,VibeCoding适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。