


GPT-6 Astra 是怎么找到问题所在的?结构分析与反馈定位过程
2026-11-06
2026-11-06 0
Gemma 的失败表明,修复循环不等于能补足所有小模型的数学推理。它主要出现算术与推导错误,局部编辑没有明确改善;这也不意味着 Astra 对 Gemma 完全没有分析能力。
Qwen 的明显瓶颈是许多回答无法结束,而 Gemma 更接近完成了答案却推错。前者可尝试减少阻碍,后者需补充或改善解题能力。移除一个干扰方向,并不自然等于提供缺少的知识与计算。
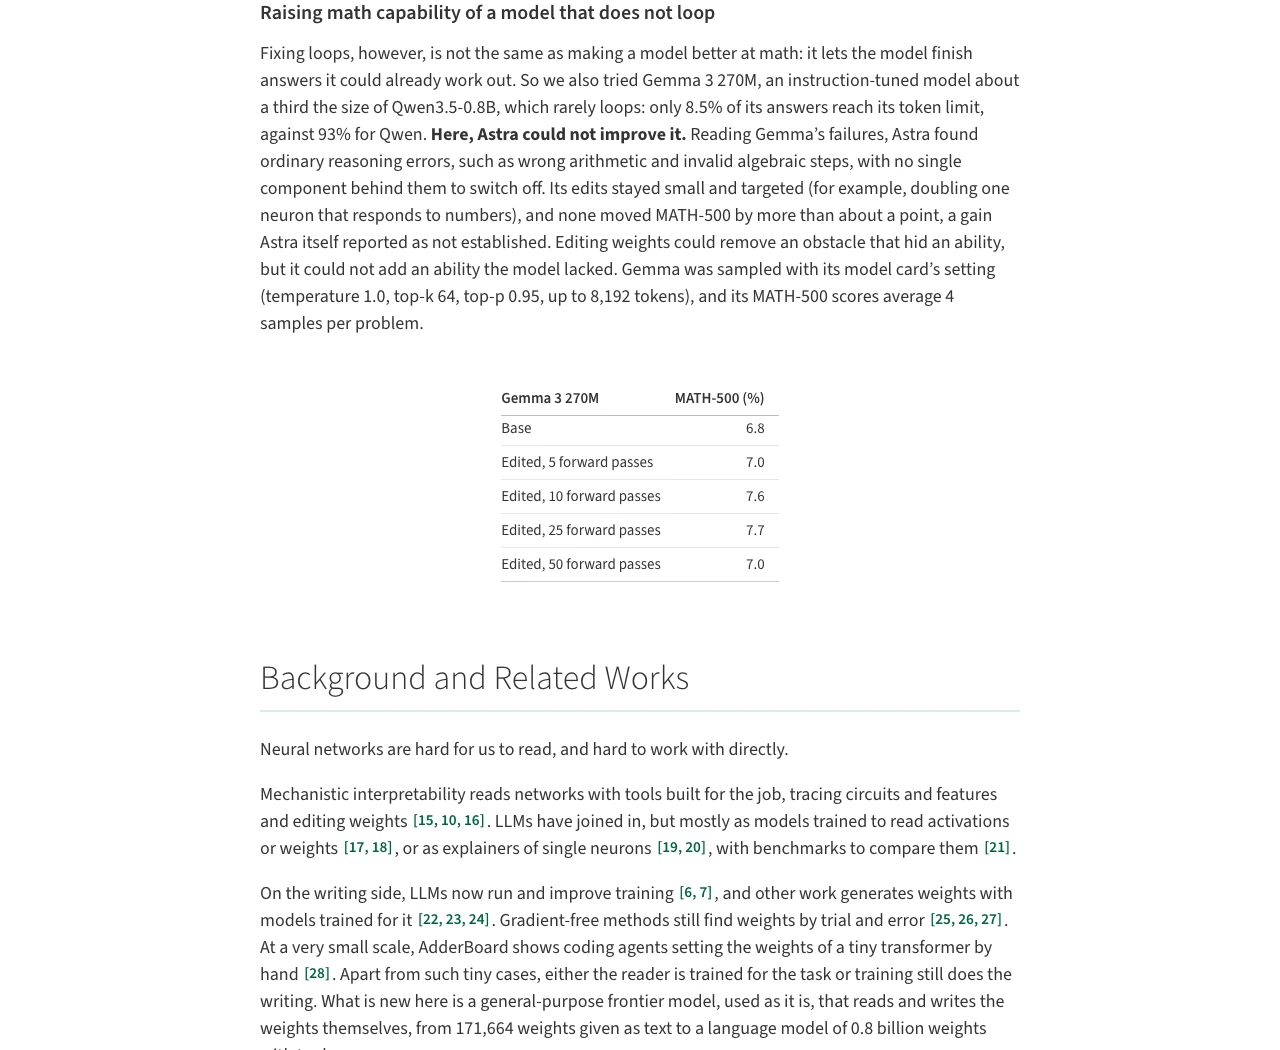
Gemma 的 MATH-500 基线为 6.8%,不同反馈预算下的编辑结果约为 7.0% 至 7.7%。这种幅度不能直接宣布为稳定提升,还需考虑采样与评测变化。它与 Qwen 的大幅改善属于不同结果。
两个模型的规模、架构和采样设置也不同,因而不能反过来用这项对照判断两个家族普遍谁更好。这里更重要的是失败模式,而不是品牌排名。
它提供了方法边界:当前编辑更擅长处理可定位的障碍,而不是通用能力生成。成功案例与失败案例一起看,才更容易判断适用条件,也能防止把研究扩展成“一句话升级所有模型”。
若只传播成功分数,开发者可能错误地把时间投入到没有同类问题的模型上,最后发现补丁既不泛化,也不能解释原因。
研究还有另一项不同任务:比较被训练为迎合用户的网络与正常网络。仅看权重时没有稳定识别成功,允许观察特定注意力反馈后情况改善。这说明“数学编辑失败”和“任何内部分析都失败”不能混为一谈。
分析、识别与干预本来就是不同能力。找到差异不等于知道它意味着什么,知道行为差异也不等于能够用小补丁改变它。
先把错误分类:循环、格式、事实、计算还是逻辑。对配置问题优先修运行环境,对知识缺失评估检索,对广泛能力不足再考虑更强模型或训练。不宜先选编辑方法,再把所有问题都解释成某个可删除方向。
若尝试编辑,保留原版、明确测试与停止条件。连续试验没有清楚改善时,应及时更换思路,而不是用单个略高分数证明方法已成功。

Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]