


GPT-6 Astra 是怎么找到问题所在的?结构分析与反馈定位过程
2026-11-06
2026-11-06 0
MATH-500 侧重竞赛型数学题,GSM8K 主要检查小学水平的多步文字算术。两种分数对应不同题集,不可直接相互比较,更不能合成一项未定义的数学智力指标。
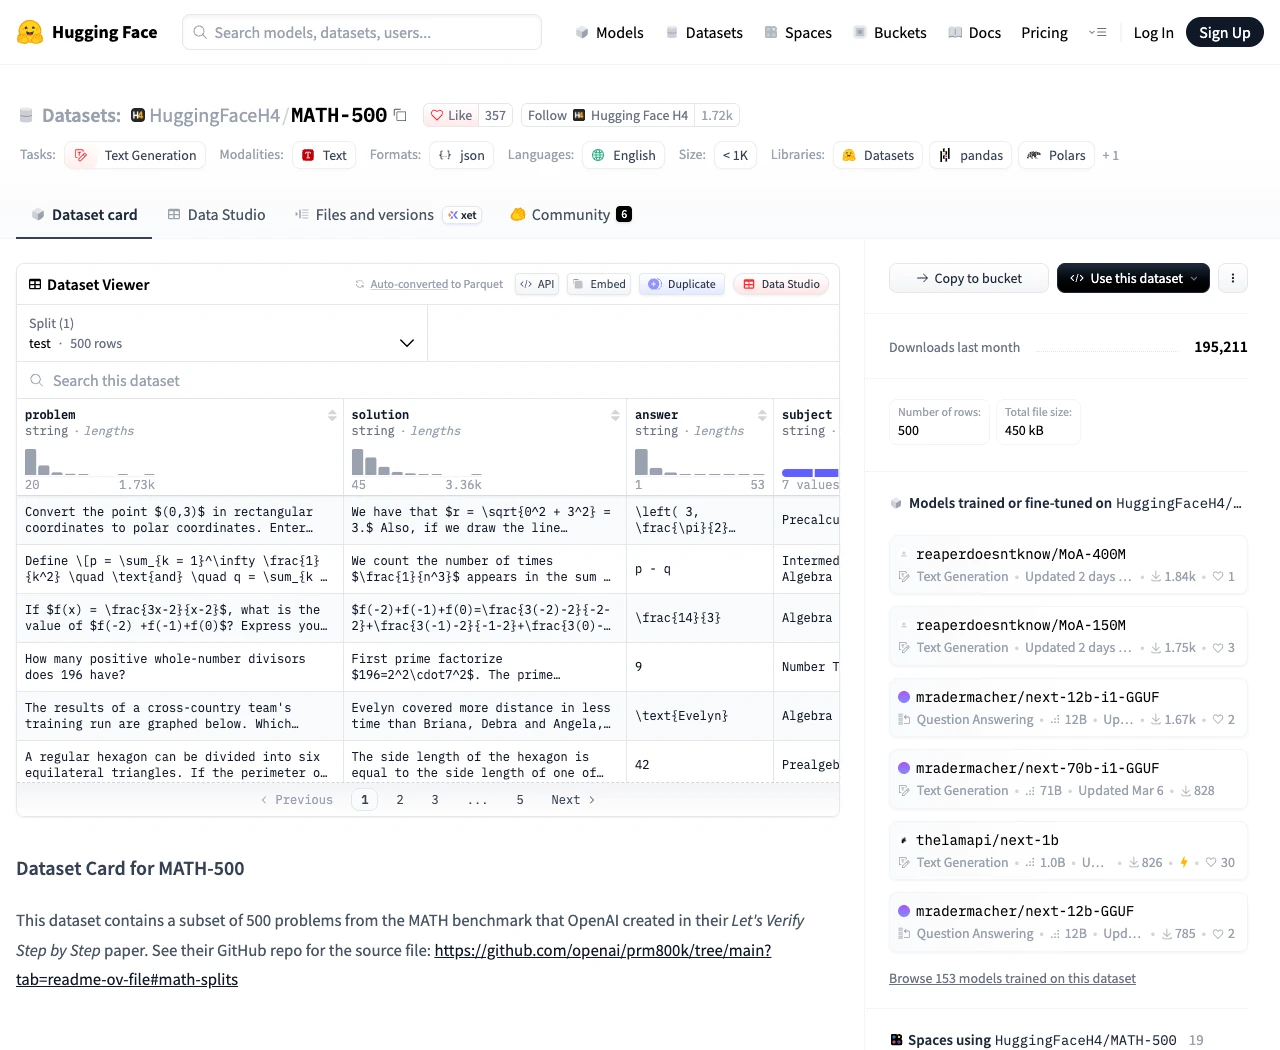
它包含 500 道来自 MATH 测试方向的题目,覆盖多个数学主题。题目往往需不止一步推导,评测通常核查最终答案是否正确。相应使用哪份数据、如何提取答案、是否调用工具,都会影响分数。
它关注自然语言描述中的数量关系与多步计算。题目看起来基础,但单位、条件、人物关系和中间步骤仍可能出错。它适合观察基础多步解题,却不能说明研究型证明能力。
数据集的训练与测试部分必须分开。用训练题进行练习和反馈,不等于可接触测试答案。若从同一题目改写出高度相似样本,也需注意评测泄漏问题。
研究可能对每道题多次采样后平均,结果不必等于只回答 500 次时的整数正确题数。平均单次成功率、允许多次尝试后只要一次成功,和多数投票成绩,都属于不同统计方式。
因而,看到小数不应立即推断它算错,也不能自行把一种采样成绩改写成另一种通过率。
| 条件 | 为什么影响结果 |
|---|---|
| 模型与权重版本 | 同一家族不同大小并非同一能力 |
| 推理与采样设置 | 会改变答案、多样性和终止行为 |
| 输出上限与工具 | 决定可使用的计算和检查空间 |
| 评分与重复次数 | 决定分数到底代表哪种成功率 |
不一定。模型可能猜中、利用格式规律,或者在过程中有错误但碰巧得到答案。对教学和业务,仍应核查推导是否有效。需证明的任务,更不能只靠一个最终数字验收。
反过来,模型思路接近但未按要求输出,也可能被评测记为失败。工程上需区分真实推理错误、格式问题与无法结束,才能有针对性改进。
把它们作为有限任务上的能力证据,并保留版本与设置。若要选本地模型,再使用自己关心的题型测试,观察第一次正确、耗时和复核成本。不宜用一道容易题或一个排行榜数字概括全部数学能力。

Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]