


GPT-6 Astra 是怎么找到问题所在的?结构分析与反馈定位过程
2026-11-06
2026-11-06 0
结果的主要争议在于基线特殊性、反馈预算与跨模型泛化。原模型大量循环会放大相对涨幅,完整评估还应比较其他合理设置、失败尝试和实际成本,而不是只看六倍数字。
若原模型大部分回答因为循环失败,修复后就可能出现很大相对增幅。这不使改善失去价值,但比较对象应包括合理推理设置、停止条件和其他可行解决方案。否则很难知道收益中有多少必须依赖权重编辑。
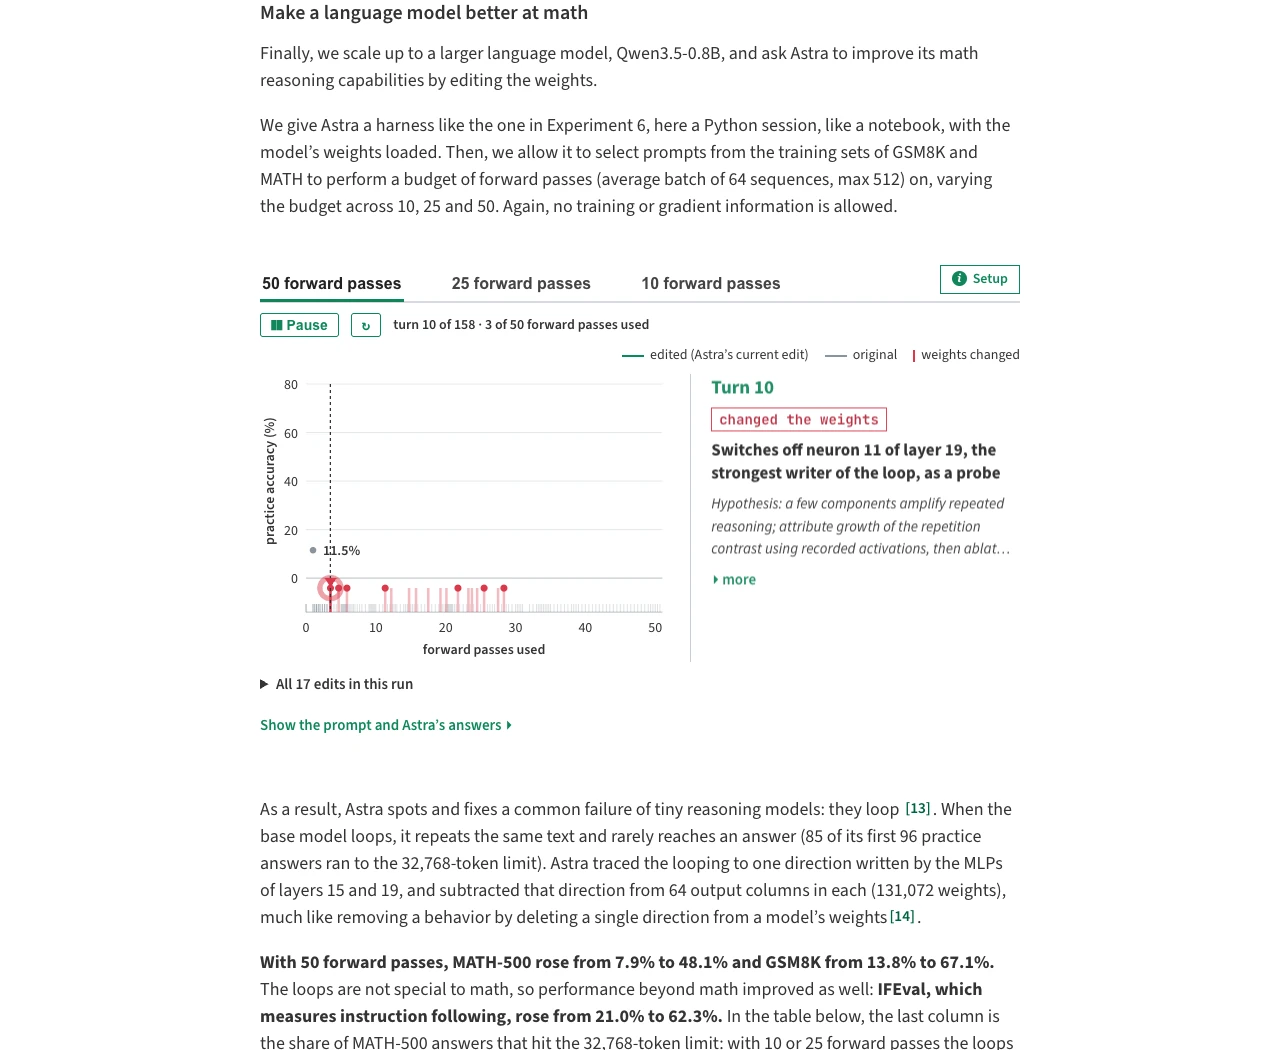
实验禁止梯度更新和训练循环,却允许一定范围的分析与前向反馈。一次前向调用还可能包含批量输入。把它传播成“完全不试验,只看一眼权重”,会省略重要条件。
完整成本应包含 Astra 调用、工具环境、目标模型计算和评测,而不只是补丁大小。是否经济,需与同质量的其他修复方式比较。
Qwen 的循环减少,与另一个较少循环模型没有明显提高,支持这次成功更接近特定瓶颈修复。它还没有证明能在同样条件下补上模型本来缺乏的推理方法。
“只是在修问题”也不应被用来否定全部价值。能把行为定位到可干预结构并验证泛化,本身有研究意义,只是需准确描述它做到了什么。
从规则明确的小游戏构造网络,与理解复杂语言模型的全部内部知识,有明显规模和信息差异。规则、源码与架构作为输入也构成先验,不能与只靠交互奖励的训练基线省略条件地比较。
公开日志和编辑模型有助于核查过程,但“文件可下载”与“不同团队稳定得到同样结果”仍是两个阶段。还应关注精确版本、软件依赖、采样、评分与候选选择是否可重复。
反复尝试后挑出最好补丁,也应与一次性成功分开记录。需保留失败尝试,才能评估方法的稳定性与实际预算。
这是一个值得进一步检验的权重读写与行为修复案例,包含成功和失败边界。后续更有价值的是跨模型、跨任务、相同预算的对照,而不是把“六倍”直接转换成对全部模型优化能力的结论。

Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]