


GPT-6 Astra 是怎么找到问题所在的?结构分析与反馈定位过程
2026-11-06
2026-11-06 0
98% 对应 Astra 在 FrontierMath Tier 4(v2)的 97.6% 四舍五入结果,有明确题集和设置。它说明该项表现强,不是模型能解答全体数学问题中 98% 的承诺。
FrontierMath 由专家编写高难数学题,Tier 4 是其中特别困难的扩展集合。v2 又与较早版本不同,题目修订和私有集合都会影响分数。不同层级使用不同题目,不能把高层级分数更高直接当成自相矛盾。
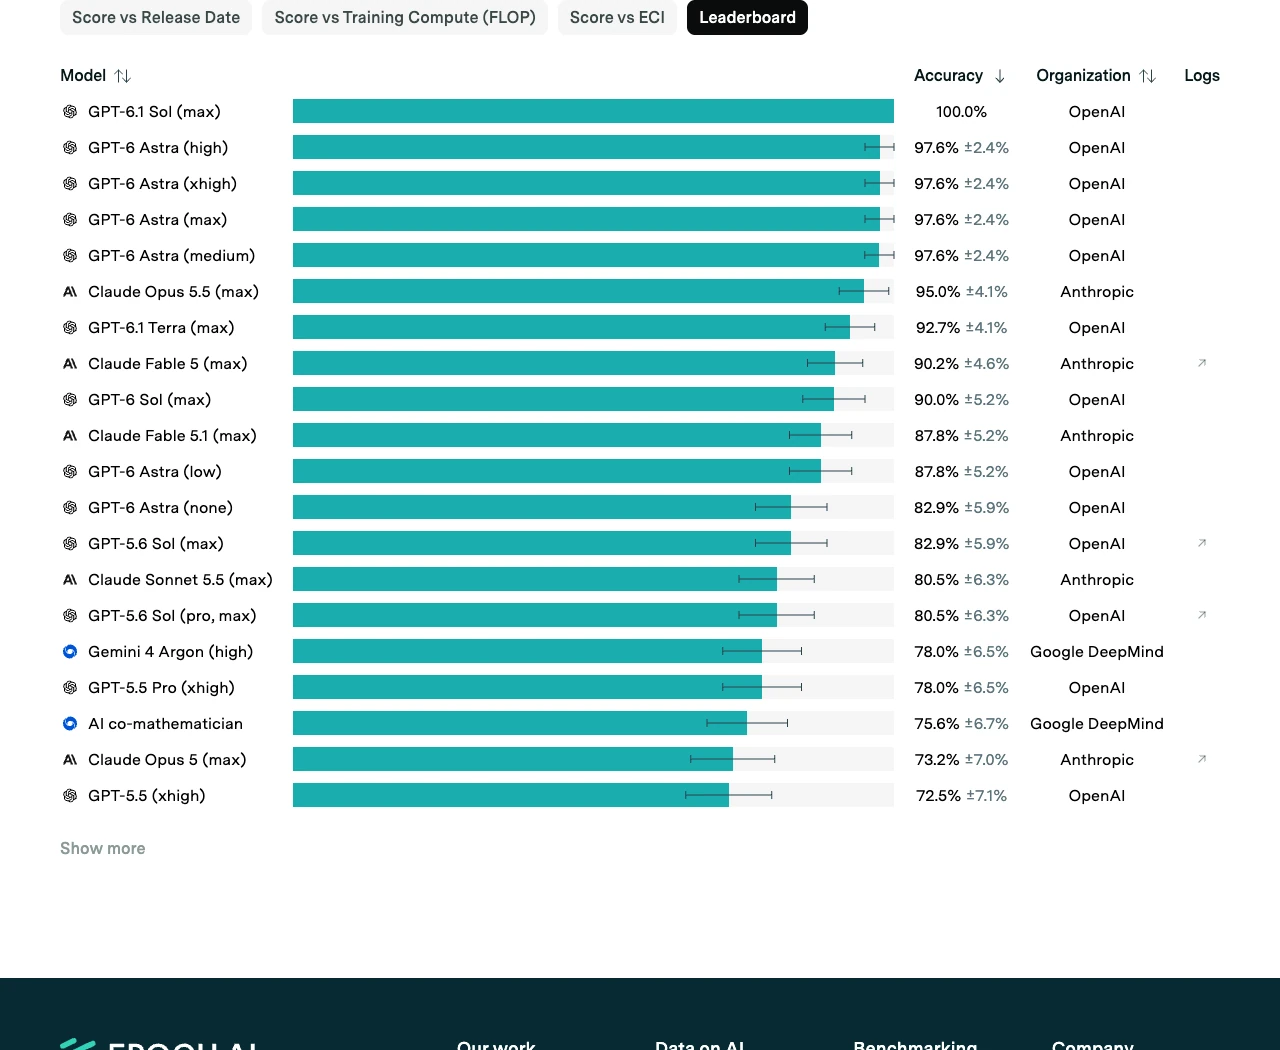
题目数量有限时,少数题目的成败会明显改变比例。一个四舍五入后的整数不应被理解成精确无误的普遍能力,也不应只凭几个百分点差距就认定任何实际任务都有同等优势。
比较时还要看推理预算、工具、尝试次数和评分方式。用高预算配置与另一模型的低预算结果直接排名,会混入资源差异。
固定基准的题目与评分要求,不等于长期未解决问题的研究过程。FrontierMath Erdős 的初始评测使用另一批问题、固定每题预算与形式化验证,Astra 的结果约为 3%。这并不推翻 Tier 4 的 98%,而是说明测量对象不同。
额外预算、多次尝试和人机协作取得的研究进展,也不应直接加进一次固定协议下的基准成绩。
需。评测应说明题目来源、保密、访问和支持安排,读者也应区分模型厂商报告与评测机构公布的数据。存在资助关系不自动证明结果无效,但利益关系和访问条件是评价证据时应保留的信息。
不能仅用“第三方”三个字替代方法核查,也不能因为成绩很高就推断题目泄漏。泄漏与污染需相应证据,不能凭印象下结论。
它足以说明该模型在这套高难题上表现很强,值得进入严肃数学任务的候选。用于教学、工程或研究时,仍需独立核实结果、证明和边界条件。
若要比较自己的工作,固定题目与预算,统计首次成功、复核和总成本。基准是能力证据,不是免检承诺;98% 应准确落在它所属的那套试卷上。

Copyright(C) 2020-2026 jiyx.com All Rights Reserved 联系方式:[email protected]